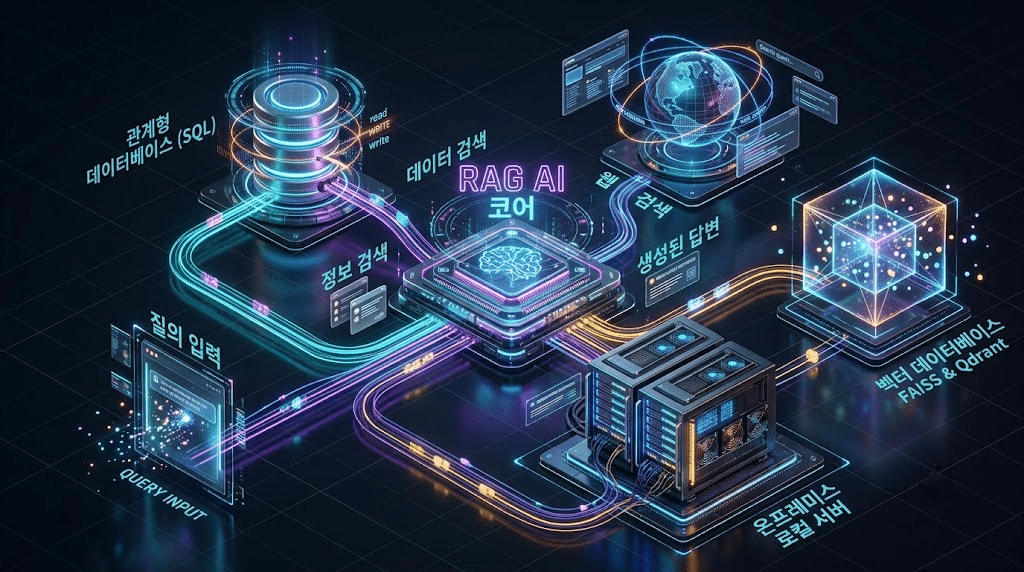
RAG 아키텍처 인공지능 애플리케이션의 개발 흐름은 단순히 프롬프트를 다듬는 수준을 넘어, 기업 내부의 방대한 데이터를 어떻게 오차 없이 찾아내고 연결할 것인가의 싸움으로 전환되었습니다. 지난 1편과 2편에서는 머신러닝의 기본 원리부터 시작해 LangChain의 기초 문법(LCEL), 단일 PDF 문서를 활용한 기본 RAG 파이프라인을 구축해 보았습니다.
하지만 사내 데이터는 PDF 문서뿐만 아니라 관계형 데이터베이스(RDB)에도 쌓여 있고, 때로는 최신 웹 검색 정보까지 결합해야 완전한 답변이 완성됩니다. 게다가 문서를 아무렇게나 자르면 AI는 문맥을 잃어버리고 엉뚱한 소리를 내뱉으며, 민감한 보안 규정 때문에 클라우드 API를 쓰지 못해 사내 독립형 로컬 LLM을 직접 올려야 하는 상황이 있을 수 있죠
1. Multi-Source & Tool-Calling RAG: 단일 검색의 한계
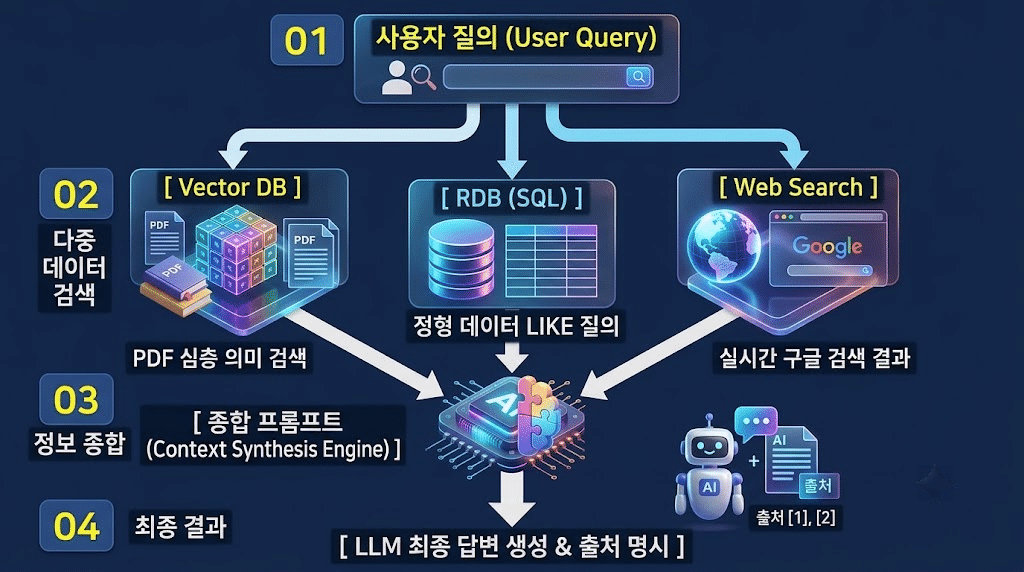
처음 단계의 RAG는 단순히 벡터 DB 하나에만 의존합니다. 하지만 사용자의 질문이 “최근 RAG 동향과 우리 사내 아티클의 연구 결과, 그리고 최신 구글 검색 기사를 종합해 줘”라면 단일 벡터 검색으로는 절대 완벽한 답을 낼 수 없습니다.
진정한 엔터프라이즈급 RAG는 1) 벡터 DB(PDF 요약), 2) 관계형 DB(SQLite SQL 조회), 3) 실시간 웹 검색(SerpAPI)이라는 세 가지 독립된 지식 소스를 능동적으로 호출하는 멀티소스(Multi-Source) 툴 통합 구조를 취합니다.
💻 멀티소스 통합 RAG 파이프라인 구현 코드
아래 코드는 SQLite 데이터베이스, 로컬 FAISS 벡터 인덱스, SerpAPI 구글 검색 결과를 각각 수집하여 하나의 통합 컨텍스트로 결합한 뒤, LLM이 종합 답변과 명확한 출처를 제시하도록 구성한 실무 파이프라인입니다.
import os
import sqlite3
# 1) 이번에는 OpenAI 대신 제미나이 구글ai를 사용하겠습니다
from langchain_google_genai import ChatGoogleGenerativeAI, GoogleGenerativeAIEmbeddings
from langchain_community.vectorstores import FAISS
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_community.utilities import SQLDatabase
from serpapi import GoogleSearch

# 0. API 키 설정 (Google AI Studio에서 발급받은 키 입력)
os.environ["GOOGLE_API_KEY"] = "YOUR-GEMINI-API-KEY"
os.environ["SERPAPI_API_KEY"] = "YOUR-SERPAPI-KEY"

# 도구 1: Vector DB 검색 및 요약 함수
def retrieve_vector_summary(query, db_path="faiss_index", k=2):
    try:
        # 제미나이 전용 임베딩 모델 (text-embedding-004)
        embeddings = GoogleGenerativeAIEmbeddings(model="models/text-embedding-004")
        db = FAISS.load_local(db_path, embeddings, allow_dangerous_deserialization=True)
        retriever = db.as_retriever(search_kwargs={"k": k})
        docs = retriever.invoke(query)
        merged = "\n\n".join(doc.page_content for doc in docs)

        # 검색된 문서 조각을 압축 요약 (가볍고 빠른 gemini-1.5-flash 사용)
        summary_prompt = ChatPromptTemplate.from_template("다음 문서를 핵심만 3줄로 요약하라:\n\n{context}")
        chain = summary_prompt | ChatGoogleGenerativeAI(model="gemini-1.5-flash", temperature=0) | StrOutputParser()
        return chain.invoke({"context": merged[:10000]})
    except Exception as e:
        return f"벡터 검색 생략 (사유: {str(e)})"

# 도구 2: 관계형 데이터베이스(SQLite) SQL 검색 함수 (동일)
def sql_query_tool(query):
    try:
        db = SQLDatabase.from_uri("sqlite:///rdb_rag.db")
        sql = f"SELECT content FROM articles WHERE title LIKE '%{query}%' OR content LIKE '%{query}%'"
        return db.run(sql)
    except Exception as e:
        return f"SQL 질의 오류: {str(e)}"

# 도구 3: 실시간 웹 스크래핑 검색 함수 (SerpAPI) (동일)
def web_search_tool(query, num_results=3):
    try:
        params = {
            "engine": "google",
            "q": query,
            "hl": "ko",
            "gl": "kr",
            "api_key": os.getenv("SERPAPI_API_KEY")
        }
        search = GoogleSearch(params)
        results = search.get_dict()
        if "organic_results" not in results:
            return "웹 검색 결과 없음"
        titles = [res.get("title", "") for res in results["organic_results"][:num_results]]
        return "\n".join(f"- {t}" for t in titles)
    except Exception as e:
        return f"웹 검색 오류: {str(e)}"

# 통합 오케스트레이터 파이프라인
def multi_source_rag(user_query):
    source_vector = retrieve_vector_summary(user_query)
    source_sql = sql_query_tool(user_query)
    source_web = web_search_tool(user_query)

    full_prompt = f"""
당신은 다중 소스 정보를 통합하는 전문 리서치 AI입니다.
아래의 3가지 서로 다른 소스에서 수집된 정보를 바탕으로 질문에 대해 명확하고 논리적인 답변을 작성하세요.

[1. 사내 벡터 DB 연구 문서 요약]:
{source_vector}

[2. 사내 RDB 정형 아티클 데이터]:
{source_sql}

[3. 실시간 구글 웹 검색 결과]:
{source_web}

사용자 질문: {user_query}
반드시 참고한 소스 출처(VectorDB, SQL, 웹)를 답변 말미에 명시하고, 경어체로 작성하세요.
"""
    # 최종 답변 조립용 고지능 모델 (gemini-3.8-pro)
    llm = ChatGoogleGenerativeAI(model="gemini-3.8-pro", temperature=0.2)
    response = llm.invoke(full_prompt)
    return response.content

# 실행 테스트
print(multi_source_rag("RAG 아키텍처"))2. 벡터 DB와 임베딩 모델의 심층 분석: FAISS vs Qdrant
RAG의 심장은 임베딩 모델(Embedder)과 벡터 데이터베이스(Vector DB)입니다. “어떤 벡터 DB를 써야 하나요?”,”어떤 임베딩 모델이 가성비가 좋을까요?
1) 임베딩 모델 비교: OpenAI vs HuggingFace BGE
- OpenAI text-embedding-3-small: 1,536차원의 고밀도 벡터를 생성합니다. 다양한 영문 및 범용 도메인에서 우수한 성능을 내지만, 상용 유료 API 호출이 필요합니다.
- BAAI/bge-small-en-v1.5 (또는 bge-m3): 384차원(M3는 1024차원)의 경량 오픈소스 임베딩 모델입니다. 차원 수가 적어 메모리와 연산량을 1/4 이하로 아끼면서도, MTEB 리더보드 최상위권의 검색 성능을 자랑합니다.
2) 벡터 저장소 비교: FAISS vs Qdrant
| 비교 항목 | Meta FAISS (CPU/GPU) | Qdrant (Rust 기반 분산 엔진) |
| 운영 형태 | 인메모리 / 로컬 라이브러리 파일 저장 (.faiss) | 독립 실행 서버 (Docker 컨테이너, 클러스터 지원) |
| 적합 환경 | 단일 인스턴스, 연구/PoC, 배치 분석 | 엔터프라이즈 프로덕션, 실시간 서비스, 마이크로서비스 |
| 주요 장점 | 추가 인프라 설치 불필요, 초경량 C++ 고속 연산 | 정교한 메타데이터 필터링, gRPC 지원, 영속적 컬렉션 관리 |
Qdrant: 여러 컴퓨터와 연결해 대량의 데이터를 체계적으로 관리하는 ‘기업용 대형 전산 서고’입니다
💻 Qdrant 로컬 컬렉션 구축 및 다중 임베딩 검색 코드
Qdrant는 Docker 컨테이너(http://localhost:6333)나 메모리 모드(:memory:)로 쉽게 띄워 사용할 수 있으며, 코사인 거리(Cosine Distance)를 기반으로 고속 유사도 검색을 지원합니다.
pip install -q langchain-core langchain-qdrant langchain-openai langchain-huggingface qdrant-clientimport os
from langchain_core.documents import Document
from langchain_qdrant import QdrantVectorStore
from langchain_openai import OpenAIEmbeddings
from langchain_huggingface import HuggingFaceEmbeddings
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, VectorParams
# 0. OpenAI API 키 설정 (본인의 실제 API 키 입력)
os.environ["OPENAI_API_KEY"] = "YOUR-OPENAI_API_KEY"
# Docker 서버 없이 메모리 내에서 즉시 실행하도록 설정
client = QdrantClient(":memory:")
# 테스트 지식 베이스
sample_docs = [
Document(page_content="RAG는 사전 학습된 LLM의 파라메트릭 메모리 한계를 외부 검색으로 보완합니다."),
Document(page_content="벡터 데이터베이스는 텍스트를 고차원 임베딩으로 변환하여 코사인 유사도로 검색합니다."),
Document(page_content="Retriever는 주어진 쿼리와 의미적 밀도가 가장 높은 상위 청크를 반환합니다.")
]
# 컬렉션 초기화 함수
def setup_qdrant_collection(collection_name, vector_size):
if client.collection_exists(collection_name):
client.delete_collection(collection_name)
client.create_collection(
collection_name=collection_name,
vectors_config=VectorParams(size=vector_size, distance=Distance.COSINE)
)
# 1. OpenAI 컬렉션 세팅 (1536차원)
setup_qdrant_collection("openai_collection", 1536)
qdrant_openai = QdrantVectorStore.from_documents(
documents=sample_docs,
embedding=OpenAIEmbeddings(model="text-embedding-3-small"),
collection_name="openai_collection",
client=client
)
# 2. BGE 로컬 오픈 모델 컬렉션 세팅 (384차원)
setup_qdrant_collection("bge_collection", 384)
qdrant_bge = QdrantVectorStore.from_documents(
documents=sample_docs,
embedding=HuggingFaceEmbeddings(model_name="BAAI/bge-small-en-v1.5"),
collection_name="bge_collection",
client=client
)
# 검색 질의 테스트
query = "외부 지식을 가져와 답변을 향상시키는 기술은?"
print("🔷 OpenAI 검색 1위:", qdrant_openai.similarity_search(query, k=1)[0].page_content)
print("🔶 BGE 오픈모델 검색 1위:", qdrant_bge.similarity_search(query, k=1)[0].page_content)3. RAG 성공의 8할, 청킹(Chunking)
아무리 뛰어난 LLM과 고가의 벡터 DB를 써도 청크(Chunk) 분할 단위가 엉망이면 RAG 시스템은 반드시 실패합니다. 청크 분할 시 발생하는 치명적인 3가지 케이스를 직접 비교해 보면 그 이유를 체감할 수 있습니다.
[원문 문서]
[1. 신입사원 연차 휴가 규정]
신입사원의 연차 휴가는 입사 첫해 1년 미만 기간 동안 1개월 개근 시 1일씩 부여되어 최대 총 11일까지 사용할 수 있습니다. 발생한 연차는 1년 이내에 모두 소진해야 하며, 미사용 연차는 수당으로 정산되지 않습니다.

[2. 점심 식대 지원 기준]
임직원의 복지를 위해 점심 식대는 법인카드로 매 영업일 기준 1인당 최대 12,000원까지 지원됩니다. 단, 주말 및 공휴일 출근 시에는 사전 승인된 특근자에 한해 석식이 15,000원까지 지원됩니다.

[3. 경조사 휴가 및 경조금]
본인 결혼 시 유급휴가 5일과 경조금 50만 원이 지급됩니다. 직계가족 회갑 및 칠순에는 유급휴가 1일이 주어집니다.

....
❌ Bad Chunk (너무 잘게 쪼갬, 15~20자 단위):
Chunk 1: "12,000원까지 지원됩니다." --> 이게 점심 식대인지, 야근 교통비인지 주어가 잘려 알 수 없음
Chunk 2: "미사용 연차는 수당으로" --> 뒤의 서술어("정산되지 않습니다")가 잘려 수당을 준다는 건지 만다는 건지 왜곡 발생
⚠️ Too Large Chunk (너무 크게 뭉뚱그림, 1,000자 이상):
Chunk 1: 연차 규정 + 점심 식대 + 결혼 축의금 규정이 하나의 거대한 덩어리로 묶임
--> "점심 밥값 얼마 나와?"라고 물었는데 연차 일수와 결혼 축의금 규정까지 통째로 검색되어 토큰 낭비 및 프롬프트 노이즈 유발
✅ Good Chunk (완결된 문맥 + 겹침, 100~200자 단위):
Chunk 1: "[2. 점심 식대 지원 기준] 임직원의 복지를 위해 점심 식대는 법인카드로 매 영업일 기준 1인당 최대 12,000원까지 지원됩니다..."
--> 질문(점심 밥값)과 정확히 부합하는 규정 단락만 독립적으로 깔끔하게 검색됨💻 청크 크기별 검색 품질 비교 실험 코드
API 키나 복잡한 C++ 라이브러리 설치 없이, HuggingFace 무료 임베딩과 LangChain 표준 텍스트 분할기를 사용해 즉시 실행할 수 있는 코드입니다.
# 사전 패키지 설치
pip install -q langchain-text-splitters langchain-huggingface langchain-community faiss-cpufrom langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_community.vectorstores import FAISS
from langchain_huggingface import HuggingFaceEmbeddings
# 1. 자연스러운 실무형 사내 규정 텍스트로 교체
raw_text = """
[1. 신입사원 연차 휴가 규정]
신입사원의 연차 휴가는 입사 첫해 1년 미만 기간 동안 1개월 개근 시 1일씩 부여되어 최대 총 11일까지 사용할 수 있습니다. 발생한 연차는 발생일로부터 1년 이내에 모두 소진해야 하며, 미사용 연차는 수당으로 정산되지 않습니다.
[2. 점심 식대 지원 기준]
임직원의 복지를 위해 점심 식대는 법인카드로 매 영업일 기준 1인당 최대 12,000원까지 지원됩니다. 단, 주말 및 공휴일 출근 시에는 사전 승인된 특근자에 한해 석식이 15,000원까지 지원됩니다.
[3. 경조사 휴가 및 경조금]
본인 결혼 시 유급휴가 5일과 경조금 50만 원이 지급됩니다. 직계가족 회갑 및 칠순에는 유급휴가 1일이 주어집니다.
"""
# 무료 로컬 임베딩
embedder = HuggingFaceEmbeddings(model_name="sentence-transformers/all-MiniLM-L6-v2")
# 2. 크기별 분할기 설정
bad_splitter = RecursiveCharacterTextSplitter(chunk_size=20, chunk_overlap=0) # 너무 작음 (주어/서술어 단절)
good_splitter = RecursiveCharacterTextSplitter(chunk_size=150, chunk_overlap=20) # 적절함 (단락 유지)
large_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=50) # 너무 큼 (잡음 유발)
# 3. 분할 및 FAISS 적재
faiss_bad = FAISS.from_texts(bad_splitter.split_text(raw_text), embedder)
faiss_good = FAISS.from_texts(good_splitter.split_text(raw_text), embedder)
# 4. 테스트 질의
query = "점심 밥값 지원 한도가 얼마인가요?"
print("❌ Bad Chunk (20자) 검색 결과:")
for doc in faiss_bad.similarity_search(query, k=2):
print(" -", repr(doc.page_content.strip()))
print("\n✅ Good Chunk (150자) 검색 결과:")
for doc in faiss_good.similarity_search(query, k=1):
print(" -", doc.page_content.strip())📌 실무 청킹(Chunking) 4대 골든 룰:
- 청크는 단어 단위가 아닌 문법적으로 완결된 문장 또는 문단 단위로 분할할 것.
- 너무 짧은 청크는 임베딩 벡터의 의미 밀도를 훼손시킨다.
- 조각 간 문맥 단절을 방지하기 위해 최소 10~20%의
chunk_overlap을 유지할 것.- 질문(Query) 또한 단순 키워드 나열이 아닌 구체적인 자연어 문장으로 기술해야 유사도 매칭률이 극대화된다.
4. 보안과 비용을 잡는 Open-Weight, Local LLM vs 상용 API
대다수 기업이 PoC(개념 증명) 단계에서는 OpenAI의 GPT와 Anthropic의 Claude를사용하지만, 실제 운영 단계에서는 두 가지 장벽에 부딪힙니다. 바로 ‘데이터 외부 유출에 대한 보안 우려’와 ‘호출량에 비례해 급증하는 API 토큰 비용’입니다.
이에 따라 최근에는 Gemma 3 1B / 4B (Google)나 알리바바의 Qwen3.5-4B / Qwen3.8 시리즈처럼 가벼우면서도 상용 모델 못지않은 한국어 지시 이행 능력을 갖춘 오픈 가중치(Open-Weight) 로컬 모델을 사내 인프라(On-Premise)에 올리는 방식이 표준으로 자리잡고 있습니다.
💻 Gradio를 활용한 Local LLM vs GPT-4o 실시간 병렬 비교 실습
Hugging Face의 pipeline과 Python의 concurrent.futures.ThreadPoolExecutor를 활용하면, 동일한 RAG 검색 문맥을 로컬 모델과 상용 GPT-4o에 동시에 전달하여 응답 품질을 웹 화면에서 실시간으로 비교 평가할 수 있습니다.
import os
import torch
import concurrent.futures
import gradio as gr
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
from openai import OpenAI

# 1. 실행 장치 자동 감지 (CUDA GPU / Apple Silicon MPS / CPU)
DEVICE = "cuda" if torch.cuda.is_available() else ("mps" if torch.backends.mps.is_available() else "cpu")

# 2. 로컬 경량 모델 로드 (Qwen3-1.7B 예시)
LOCAL_MODEL = "Qwen/Qwen3-1.7B"
tokenizer = AutoTokenizer.from_pretrained(LOCAL_MODEL)
model = AutoModelForCausalLM.from_pretrained(
    LOCAL_MODEL,
    torch_dtype=torch.float16 if DEVICE != "cpu" else torch.float32,
    device_map="auto" if DEVICE == "cuda" else None
)
if DEVICE in ["mps", "cpu"]:
    model = model.to(DEVICE)

generator = pipeline("text-generation", model=model, tokenizer=tokenizer)

# 3. 모델 호출 함수 정의
def call_local_llm(prompt):
    messages = [{"role": "user", "content": prompt}]
    formatted = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
    out = generator(formatted, max_new_tokens=256, do_sample=True, temperature=0.7)
    return out[0]["generated_text"].split(formatted)[-1].strip()

def call_commercial_gpt(prompt):
    client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
    res = client.chat.completions.create(
        model="gpt-4o",
        messages=[{"role": "user", "content": prompt}],
        temperature=0.2
    )
    return res.choices[0].message.content.strip()

# 4. 병렬 비교 함수
def compare_both_llm(query):
    context = "RAG는 외부 데이터베이스를 검색하여 최신 지식을 바탕으로 환각 없이 응답을 생성하는 기술이다."
    full_prompt = f"문맥: {context}\n\n질문: {query}\n\n위 문맥만을 바탕으로 간결하게 답하세요."

    with concurrent.futures.ThreadPoolExecutor(max_workers=2) as executor:
        f_local = executor.submit(call_local_llm, full_prompt)
        f_gpt = executor.submit(call_commercial_gpt, full_prompt)
        return f_local.result(), f_gpt.result()

# 5. Gradio 인터페이스 구동
demo = gr.Interface(
    fn=compare_both_llm,
    inputs=gr.Textbox(label="질문 입력", value="RAG의 주된 목적은 무엇인가?"),
    outputs=[
        gr.Textbox(label="🦙 Local Open-Weight 응답", lines=8),
        gr.Textbox(label="💬 Commercial Cloud (GPT-4o) 응답", lines=8)
    ],
    title="RAG 기반 Local LLM vs Commercial LLM 실시간 비교 대시보드"
)

# 로컬 브라우저에서 실행
# demo.launch(inbrowser=True)
5. RAG 완성하기: SQLite + PDF + Qwen3
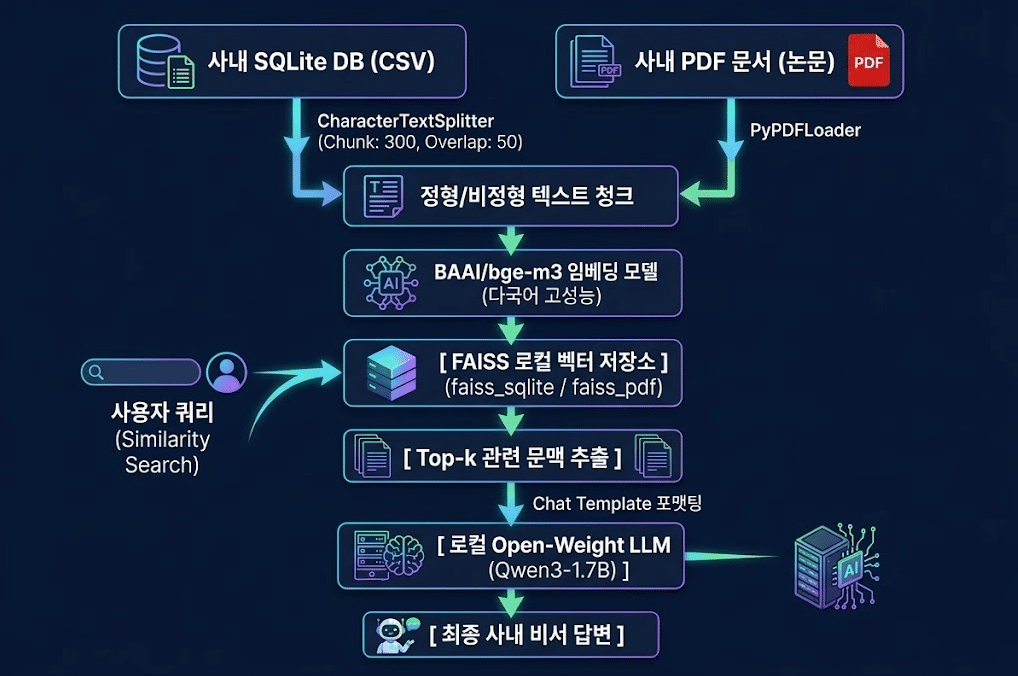
이제 배운 모든 지식을 하나로 결합할 시간입니다. 사내 데이터베이스(SQLite)의 지식 기사와 논문 PDF 자료를 BGE-M3 다국어 고성능 임베딩 모델을 통해 FAISS에 인덱싱하고, 순수 사내 하드웨어에서 돌아가는 Qwen3 로컬 언어 모델을 붙여 완전한 100% 로컬 오프라인 RAG 시스템을 구축합니다.
💻 완전 독립형 온프레미스 RAG 실전 파이프라인 코드
외부 인터넷 연결이나 유료 API 호출 없이, 내부 데이터만으로 완벽하게 돌아가는 로컬 RAG 전체 파이프라인입니다.
import os
import torch
from pathlib import Path
from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import CharacterTextSplitter
from langchain_huggingface import HuggingFaceEmbeddings
from langchain_community.vectorstores import FAISS
from transformers import AutoModelForCausalLM, AutoTokenizer

# 1. 고성능 BGE-M3 임베딩 로드
bge_embedder = HuggingFaceEmbeddings(model_name="BAAI/bge-m3")

# 2. 문서 분할 및 로컬 FAISS 인덱스 생성
splitter = CharacterTextSplitter(chunk_size=300, chunk_overlap=50, separator="\n")

#   attention.pdf = 입력파일,    ./faiss_pdf = FAISS 벡터 데이터베이스 담을 폴더
def build_pdf_vector_db(pdf_path="attention.pdf", save_folder="./faiss_pdf"):
    loader = PyPDFLoader(pdf_path)
    pages = loader.load()
    split_docs = []
    for page in pages:
        chunks = splitter.split_text(page.page_content)
        split_docs.extend(splitter.create_documents(chunks))

    vector_db = FAISS.from_documents(split_docs, bge_embedder)
    vector_db.save_local(save_folder)
    return vector_db

# 3. 로컬 Qwen3 언어 모델 설정
MODEL_NAME = "Qwen/Qwen3-1.7B"
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
local_model = AutoModelForCausalLM.from_pretrained(
    MODEL_NAME,
    torch_dtype=torch.float16 if torch.cuda.is_available() else torch.float32,
    device_map="auto" if torch.cuda.is_available() else None
)

def generate_local_response(query, context):
    messages = [
        {
            "role": "system",
            "content": "당신은 한국어에 능통한 사내 전문 AI 비서입니다. 제공된 문맥만을 근거로 정확하고 간결하게 답변하세요."
        },
        {
            "role": "user",
            "content": f"[문서 문맥]:\n{context}\n\n[질문]:\n{query}\n\n답변:"
        }
    ]
    prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)
    inputs = tokenizer(prompt, return_tensors="pt").to(local_model.device)

    with torch.inference_mode():
        output = local_model.generate(**inputs, max_new_tokens=256, temperature=0.3, do_sample=True)

    generated_tokens = output[:, inputs["input_ids"].shape[1]:]
    return tokenizer.batch_decode(generated_tokens, skip_special_tokens=True)[0].strip()

# 4. RAG 엔드투엔드 실행 테스트
# (사전에 build_pdf_vector_db가 실행되어 인덱스가 저장되어 있다고 가정)
vector_db = FAISS.load_local("./faiss_pdf", bge_embedder, allow_dangerous_deserialization=True)

query = "Attention 메커니즘에서 Self-Attention의 핵심 개념은 무엇인가?"
matched_docs = vector_db.similarity_search(query, k=2)
retrieved_context = "\n\n".join(doc.page_content for doc in matched_docs)

final_answer = generate_local_response(query, retrieved_context)

print("="*60)
print(f"질문: {query}")
print("="*60)
print(f"🤖 사내 Local RAG 답변:\n{final_answer}")
이 구조를 활용하면 회사의 인사 규정, 회계 전표 데이터, 제품 매뉴얼 등 극비 보안 문서라도 단 1바이트의 외부 데이터 유출 없이 완벽한 사내 질의응답 시스템을 구축할 수 있습니다.
💡 독자가 가장 궁금해할 실전 Q&A
Q1. FAISS와 Qdrant 중 프로젝트 초기에는 무엇을 선택해야 할까요?
- FAISS 추천: 로컬 PC나 단일 GPU 서버에서 빠르게 데모를 개발하거나, 배치(Batch) 임베딩 및 연구 목적일 때 가장 가볍고 강력합니다. (‘내 방의 작은 책꽂이’)
- Qdrant 추천: 여러 서비스에서 동시 접속하거나, REST/gRPC API 기반의 실시간 CRUD(추가/수정/삭제) 및 특정 사용자 ID별 메타데이터 필터링이 필요한 프로덕션 서비스에 적합합니다. (‘기업용 대형 전산 서고’)입니다
Q2. 임베딩 모델 선택 시 BGE-M3가 각광받는 이유는 무엇인가요?
- 한국어를 포함한 다국어를 매우 잘 이해하고, 긴 문서(8k 토큰)도 거뜬하며, 키워드 검색과 의미 검색(하이브리드)을 모델 하나로 끝낼 수 있는 무료 오픈소스이기 때문에 1순위로 많이 씁니다!
Q3. 청크 크기(Chunk Size)를 결정할 때 가장 흔히 저지르는 실수는?
- 단순히 글자 수나 토큰 수만 보고 문장의 중간을 잘라버려 주어와 서술어가 분리되는 참사입니다.
- 마침표(
.)나 줄바꿈(\n)처럼 말이 완전히 끝나는 문단 단위로 잘라야 주어와 서술어가 살아남고, 문맥을 공유할 수 있도록 15~20% 정도의 앞뒤 문장을 겹치게(Overlap) 잘라주면 문맥이 끊기는 일을 완벽하게 막을 수 있습니다.
Q4. 1B~3B 크기의 초경량 로컬 모델(Qwen3, LLaMA-3.2)도 RAG에 충분한가요?
- 자체 지식을 물어보면 매개변수가 작아 한계가 있지만, RAG 시스템에서는 검색기(Retriever)가 핵심 자료를 정확히 찾아 떠먹여 주기 때문에, 1B~3B 소형 모델만으로도 비용과 보안 걱정 없이 훌륭한 실무형 사내 AI 비서를 구축할 수 있습니다.
📚 참고 문헌 및 공식 출처 (References)
본 포스팅에서 다룬 아키텍처와 최신 구현체에 대한 원저 논문 및 공식 문서입니다.
1. 핵심 원저 논문
- [RAG 원저 논문] Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (NeurIPS 2020): 외부 지식 검색과 사전 학습 언어 모델을 결합한 RAG의 창시 논문
- [트랜스포머 원저 논문] Attention Is All You Need (NeurIPS 2017): 현대 모든 LLM과 임베딩 인코더의 뼈대가 된 Self-Attention 메커니즘
- [FAISS 벡터 검색 논문] Billion-scale similarity search with GPUs (IEEE Trans. Big Data): 고차원 밀집 벡터의 대규모 유사도 인덱싱 원리
- [BGE 임베딩 기술 보고서] BGE M3-Embedding: Multi-Lingual, Multi-Functionality, Multi-Granularity (arXiv 2024): 다국어 고성능 임베딩 모델의 구조 및 벤치마크
- [Qwen 기술 보고서] Qwen Technical Report (arXiv 2023): 오픈 가중치 언어 모델의 사전 학습 및 한국어/다국어 추론 아키텍처
2. 공식 개발 프레임워크 및 문서
- LangChain 공식 문서 (python.langchain.com): Document Loaders, VectorStores, LCEL 파이프라인 표준 가이드
- Qdrant 공식 문서 (qdrant.tech/documentation): Rust 기반 고성능 벡터 데이터베이스 아키텍처 및 파이썬 SDK 가이드
- Hugging Face Transformers 공식 문서 (huggingface.co/docs): AutoModelForCausalLM 및 로컬 파이프라인 최적화 사양
- SerpAPI 공식 문서 (serpapi.com): 실시간 구글 검색 엔진 연동 API 레퍼런스