지난 시간 자율주행 알고리즘 판단편에 이어서, 오늘 다뤄볼 주제는 딥러닝 엔지니어링의 꽃이라고 할 수 있는 ‘자율주행 모델 경량화편’입니다.
우리가 연구실 GPU(서버) 환경에서 만든 거대하고 무거운 AI 모델은 실제 자율주행 차량의 엣지 디바이스(Edge Device)에 바로 올릴 수 없습니다. 제한된 전력, 부족한 VRAM, 그리고 무엇보다 ‘서멀 스로틀링(Thermal Throttling, 발열로 인한 성능 저하)’이라는 혹독한 물리적 제약이 존재하기 때문입니다.
자율주행의 엣지 환경에서 모델을 구동하기 위해서는 무조건적인 파라미터 팽창을 멈추고, 적은 연산량(FLOPs)으로 높은 정확도를 달성하는 파레토 최적(Pareto Optimal) 상태를 찾아야 합니다. 지금부터 클라우드 AI를 엣지 AI로 변환하는 ‘데이터 및 아키텍처 다이어트’ 전략과 실제 배포 마지노선에 대해 깊이 있게 알아보겠습니다.
무엇을 가볍게? : 데이터와 가중치 다이어트
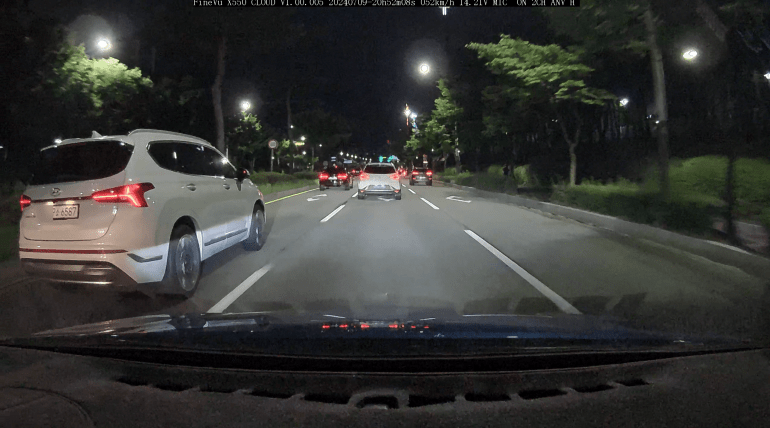
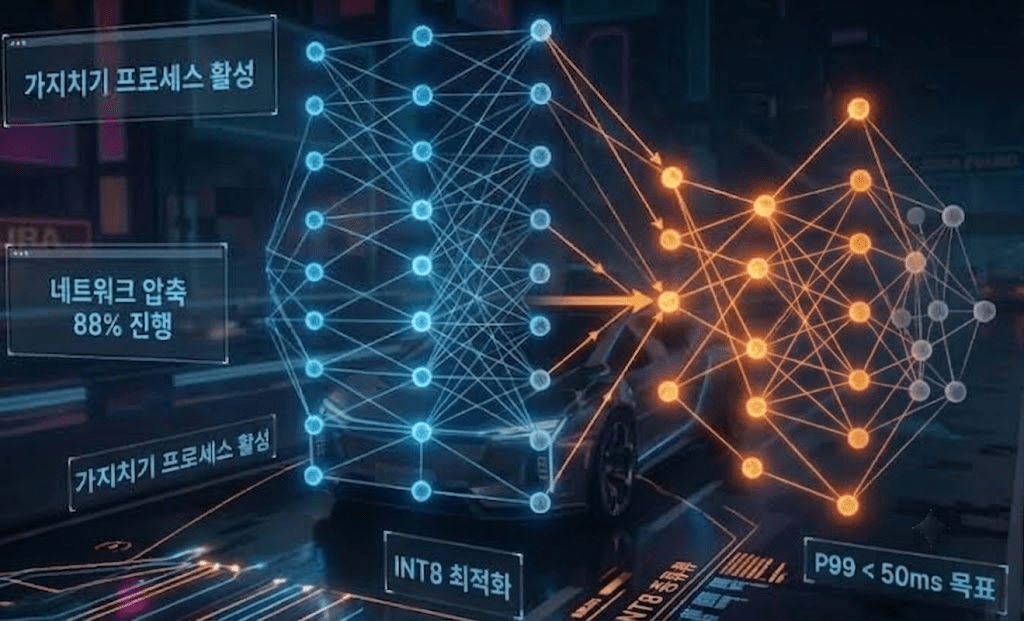
자율주행 모델 경량화의 첫걸음은 위 원본 이미지에 불필요한 입력 데이터와 파라미터를 덜어내는 것입니다.
1.1 데이터 다이어트: RoI와 AoI의 유연한 설정
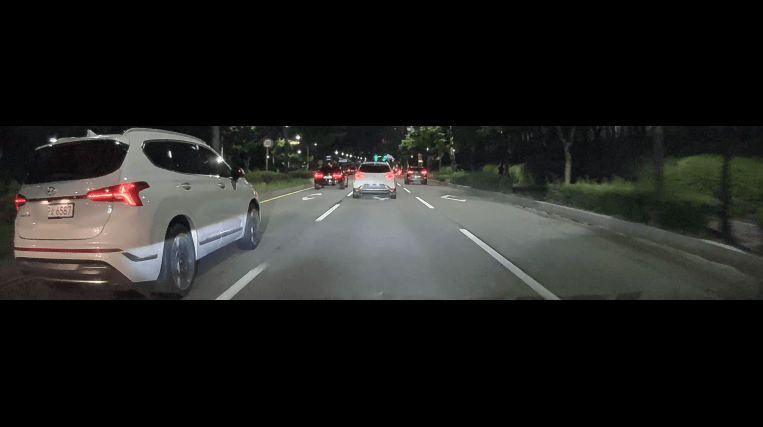
- RoI (Region of Interest): 자율주행 카메라에 잡히는 하늘, 건물의 상단 등은 주행에 직접적인 도움을 주지 않습니다. 정적 배경을 제외하고 도로 차선 중심 40% 영역만을 추출하는 등 센서 데이터의 공간적 마스킹을 수행합니다. 주행 속도에 따라 변하는 Dynamic RoI, 돌발 객체에 반응하는 Context RoI로 진화하고 있습니다.
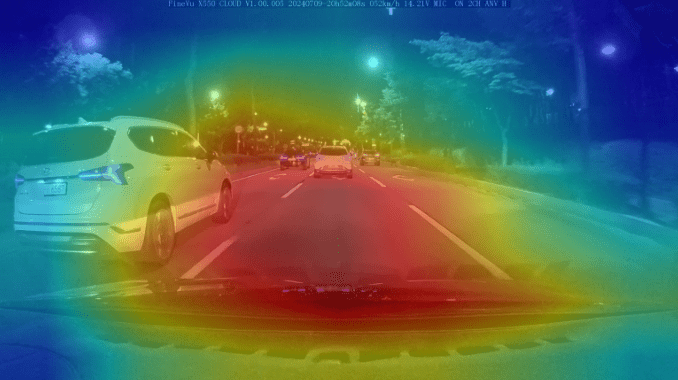
- AoI (Area of Interest): “어디를 집중해서 볼 것인가?”를 정의합니다. 보행자 출현 가능성이 높은 횡단보도나 교차로의 신호등 변화와 같은 의미적 정보에 주목하여 Attention Map이나 Heatmap 형태로 표현합니다.
1.2 모델 가중치 다이어트: 3대 핵심 기법
학습된 모델을 하드웨어 칩셋(CPU의 TFLite, GPU의 TensorRT 등)에 맞게 최적화하는 과정입니다.
- 가지치기 (Network Pruning): 모델 결과에 기여도가 0에 가까운 불필요한 가중치(Weight)와 편향(Bias) 연결을 식별하여 삭제합니다.
- 양자화 (Quantization): 32비트 부동소수점(FP32)으로 이루어진 모델의 가중치 정밀도를 8비트 정수(INT8)로 낮춥니다. 이 변환을 통해 메모리 점유율을 75% 절감(1/4 수준)할 수 있으며, 추론 속도가 비약적으로 향상됩니다.
- 지식 증류 (Knowledge Distillation): 방대한 지식을 가진 스승(Teacher) 모델의 부드러운 확률 분포(Soft Target Loss)와 중간층 특징맵을 가볍고 빠른 학생(Student) 모델에게 모방 학습시켜, 아키텍처를 압축하면서도 성능 손실을 방어합니다.
백본(Backbone)아키텍처의 혁신적인 구조적 경량화
사후 최적화(Pruning 등)만으로는 한계가 있습니다. 처음부터 가벼운 아키텍처를 설계하는 것이 필수적이며, 그 중심에 MobileNetV2와 Depthwise Separable Convolution이 있습니다.
2.1 Depthwise Separable Convolution (분리형 합성곱)
기존의 표준 합성곱(Standard Convolution) 연산은 입력 공간의 크기와 커널, 그리고 입력 채널과 출력 채널이 한 번에 곱해지며 기하급수적인 연산량을 유발합니다. 이를 해결하기 위해 공간과 채널 연산을 분리합니다.
- Depthwise Conv: 각 채널마다 별도의 2D 필터(3×3)를 적용하여 채널 간 관계는 무시하고 공간적 특징만 추출합니다.
- Pointwise Conv: 1×1 필터로 분리된 여러 채널의 정보를 하나로 믹싱(통합)하여 출력 차원을 조절하고 비선형성을 부여합니다.
이러한 분리 기법을 통해 표준 합성곱 대비 연산량을 약 11~12% 수준으로 극적으로 감소(88% 절감)시킬 수 있습니다. 아래 PyTorch 코드로 파라미터 수 차이를 직접 확인해 보겠습니다.
import torch
import torch.nn as nn

# 1. 표준 합성곱 (Standard Convolution)
class StandardConvBlock(nn.Module):
    def __init__(self, in_channels, out_channels):
        super().__init__()
        self.conv = nn.Conv2d(in_channels, out_channels, kernel_size=3, padding=1, bias=False)
        self.bn = nn.BatchNorm2d(out_channels)
        self.relu = nn.ReLU()

    def forward(self, x):
        return self.relu(self.bn(self.conv(x)))

# 2. 분리형 합성곱 (Depthwise Separable Convolution)
class DepthwiseSeparableConvBlock(nn.Module):
    def __init__(self, in_channels, out_channels):
        super().__init__()
        # Depthwise: 각 채널별 독립 필터링 (groups=in_channels)
        self.depthwise = nn.Conv2d(in_channels, in_channels, kernel_size=3, padding=1,
                                   groups=in_channels, bias=False)
        self.bn1 = nn.BatchNorm2d(in_channels)
        self.relu1 = nn.ReLU()
        # Pointwise: 1x1 커널을 통한 채널 간 정보 통합
        self.pointwise = nn.Conv2d(in_channels, out_channels, kernel_size=1, bias=False)
        self.bn2 = nn.BatchNorm2d(out_channels)
        self.relu2 = nn.ReLU()

    def forward(self, x):
        x = self.relu1(self.bn1(self.depthwise(x)))
        return self.relu2(self.bn2(self.pointwise(x)))

# 파라미터 수 비교 (입력 채널: 32, 출력 채널: 64 기준)
# Standard Conv 파라미터: 18,560개
# Depthwise Separable 파라미터: 2,528개 (기존 대비 단 13.6% 수준!)
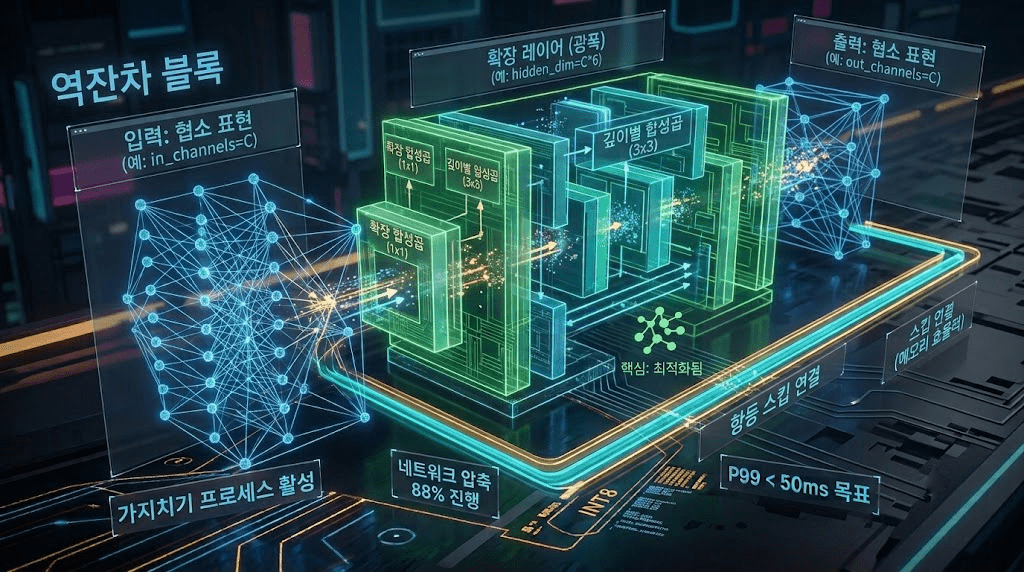
2.2 역잔차 구조 (Inverted Residuals)와 확장 계수(t=6)
기존 ResNet의 Bottleneck 구조는 채널을 줄였다가 넓히는(Wide-Narrow-Wide) 형태였습니다. 반면 경량화 백본인 MobileNetV2는 이를 뒤집은 Narrow-Wide-Narrow (역잔차 구조)를 채택합니다.
입력 채널을 중간 확장층(Expansion Layer)에서 6배(확장 계수 t=6) 늘려 고차원 특징 공간을 확보한 뒤 Depthwise 연산을 수행하고, 마지막에 다시 채널을 압축합니다. 이때 중요한 점은 마지막 압축 레이어(Linear Bottleneck)에서는 저차원 정보 파괴를 막기 위해 활성화 함수(ReLU)를 생략한다는 것입니다. 또한 날씬한 병목 구간(Narrow)끼리만 Skip Connection으로 묶어 메모리 대역폭 한계(Memory Bandwidth Bottleneck)를 훌륭하게 극복합니다.
class InvertedResidualBlock(nn.Module):
    def __init__(self, in_channels, out_channels, expansion_factor=6):
        super().__init__()
        hidden_dim = in_channels * expansion_factor # 6배 폭발적 확장

        self.block = nn.Sequential(
            # 1. Expansion Layer (1x1 Conv) 좁은 채널 -> 6배 넓은 공간 확보
            nn.Conv2d(in_channels, hidden_dim, kernel_size=1, bias=False),
            nn.BatchNorm2d(hidden_dim),
            nn.ReLU6(inplace=True), # 상한선이 있는 ReLU6
            # 2. Depthwise Layer (3x3 Conv) 넓어진 공간에서 최소 연산으로 공간 정보 추출
            nn.Conv2d(hidden_dim, hidden_dim, kernel_size=3, padding=1, groups=hidden_dim, bias=False),
            nn.BatchNorm2d(hidden_dim),
            nn.ReLU6(inplace=True),
            # 3. Linear Bottleneck (1x1 Conv, 활성화 함수 생략) 압축
            nn.Conv2d(hidden_dim, out_channels, kernel_size=1, bias=False),
            nn.BatchNorm2d(out_channels)
        )
        self.use_skip_connection = (in_channels == out_channels)

    def forward(self, x):
        if self.use_skip_connection:
            return x + self.block(x) # 다이렉트 결합으로 메모리 버퍼 최소화
        return self.block(x)
실전 배포 마지노선: 평균의 함정을 벗어나라
자율주행 모델 경량화 작업이 끝났다면 실제 차량에 배포를 해야 합니다. 하지만 학술적인 지표(mIoU, RMSE)만 믿고 배포했다가는 큰 사고로 이어질 수 있습니다. 평균 수치의 함정과 클래스 불균형 문제를 극복하는 것이 진정한 엔지니어의 역량입니다.
mIoU와 RMSE의 통계적 착시
- mIoU의 한계: 자율주행 이미지의 85%는 도로나 건물 같은 배경입니다. 모델이 전방의 보행자나 얇은 가로등(Pole)을 미탐지(False Negative)하여도 배경만 잘 맞추면 mIoU는 90점을 상회합니다. 자율주행에서 실제 안전의 조건은 면적과 상관없이 장애물을 단 하나라도 정확하게 인지하는 것입니다.
- 해결책: 일반 구역 대비 10배 이상의 패널티를 부여하는 클래스 가중치(Class Weight)를 적용합니다. 또한 단순히 Cross Entropy Loss를 쓰는 것이 아니라, 오탐지(False Positive)보다 훨씬 치명적인 미탐지(False Negative)에 더 큰 패널티를 부여하는 Tversky Loss(비대칭 가중치)를 도입하여 생존 판단력을 극대화합니다.
- Depth Error (거리 오차) 희석 효과: 원거리(100m 앞)의 사소한 오차가 코앞(5m)의 50cm 오차를 평균의 함정(RMSE)으로 희석시킵니다. 이를 방지하기 위해 거리에 따라 마지노선을 차등 적용하는 Depth Binning 전략을 사용합니다. (예: 0~15m 초근거리는 오차 ±10cm 이내 강제, 40m 이상은 ±2m 허용 등)
50ms 마지노선과 P99 Tail Latency
모델의 ‘평균’ 추론 속도가 아무리 빨라도, 복잡한 교차로에서 순간적으로 연산이 몰려 시스템이 일시적으로 동결되는 랙(Lag) 현상이 발생하면 안전을 보장할 수 없습니다.
따라서 최악의 성능 중 99등인 P99 Latency(꼬리 지연)를 관리해야 합니다. 시속 100km로 주행 시 차량은 50ms 동안 약 1.4m를 무제어 상태로 이동합니다. 이를 막기 위해 카메라 입력부터 AI 연산(33ms, 즉 30FPS), 그리고 제어기 신호 전달(17ms)까지 걸리는 End-to-End 총 지연 시간을 50ms 이내로 완벽히 통제해야만 배포 승인이 떨어집니다.
배포 승인 3대 실전 지표 결론
엔지니어는 파레토 전선 위에서 다음 3가지의 강력한 마지노선을 충족해야 자율주행 차량의 브레인으로 인정받을 수 있습니다.
- Object Recall (객체 재현율 99.9% 이상): Critical Zone 내 인명 충돌 방지를 위한 미탐지 제로화.
- Flicker Rate (깜빡임 비율 0.1% 이하): 인지 결과가 프레임별로 사라졌다 나타나면 차량 제어가 요동치거나 유령 제동을 유발하므로 시계열적 불안정성을 통제해야 합니다.
- Temporal Stability (시간적 일관성): 터널 진입이나 역광 등 조도 변화에도 흔들림 없는 성능을 유지.
결론
자율주행 환경에서 모델을 경량화한다는 것은 단순히 모델 용량을 줄이는 작업이 아닙니다. RoI/AoI로 불필요한 입력을 차단하고, INT8 양자화 및 지식 증류로 무거운 연결을 덜어내며, MobileNetV2와 같은 고효율 백본 아키텍처로 파라미터를 11% 수준까지 압축하는 총체적 시스템 설계 과정입니다.
고효율 알고리즘과 구조적 최적화 기술들이 시스템에 녹아들 때 비로소 서멀 스로틀링이나 배터리 이슈 없이 P99 50ms 이내에 생명과 직결되는 실시간 제어 명령을 안전하게 처리할 수 있습니다. 이것이 바로 학계를 넘어 실제 산업계의 배포 수준을 결정짓는 자율주행 엔지니어링의 정수입니다.
FAQ
- Q1. 모델 가중치를 INT8로 양자화(Quantization)하면 인식 정확도가 크게 떨어지지 않나요?
A. 단순 변환 시 미세한 정확도 손실이 있을 수 있으나, 양자화 인식 훈련(QAT, Quantization-Aware Training)이나 적절한 보정(Calibration)을 거치면 실제 자율주행 인지 정확도 저하는 1% 미만으로 방어하면서 연산 속도 향상과 75% 메모리 절감 효과를 온전히 누릴 수 있습니다. - Q2. MobileNetV2 역잔차 구조에서 활성화 함수(ReLU)를 제거하는 ‘Linear Bottleneck’을 적용하는 구체적인 이유는 무엇인가요?
A. 저차원 공간에 비선형 활성화 함수(예: ReLU의 음수 영역 0 처리)를 강하게 적용하면 중요한 매니폴드(Manifold) 정보가 파괴되기 때문입니다. 고차원으로 확장된 구간($t=6$)에서만 비선형성을 부여하고, 다시 좁은 병목으로 압축할 때는 선형(Linear) 상태를 유지해야 특징 유실을 차단할 수 있습니다. - Q3. P99 지연 시간(Tail Latency) 측정 시 평균값(P50)보다 P99가 자율주행에서 더 중요한 이유는 무엇인가요?
A. 자율주행은 생명과 직결된 실시간 시스템(Hard Real-time System)이기 때문입니다. 평균 지연 시간이 20ms로 우수하더라도, 복잡한 교차로나 객체 폭증 상황에서 100번에 1번 꼴로 100ms 이상의 시스템 동결(Lag)이 발생하면 시속 100km 주행 시 조향·제동 명령 공백으로 인해 곧바로 치명적인 사고로 이어집니다. - Q4. 클래스 불균형 해결을 위해 보행자 가중치를 100배 이상으로 크게 주면 안 되나요?
A. 가중치를 과도하게 설정하면 손실 함수가 보행자 검출에만 과민해져, 도로의 그림자, 타이어 자국, 전봇대의 일부까지 보행자로 오탐지(False Positive)하는 비율이 급증합니다. 이는 주행 중 이유 없이 차량이 급제동하는 유령 제동(Phantom Braking)을 유발하여 후방 추돌 사고의 원인이 됩니다. - Q5. 지식 증류(Knowledge Distillation) 학습 시 Soft Target Loss와 Hard Target Loss를 왜 함께 사용하나요?
A. 정답 라벨(Hard Target)만을 보면 클래스 간의 상관관계(예: ‘오토바이’와 ‘자전거’의 시각적 유사성)를 배울 수 없습니다. 스승 모델의 부드러운 확률 분포(Soft Target)를 함께 전달받아야 학생 모델이 특징점 간의 관계와 일반화 능력을 함께 흡수할 수 있습니다.
참고 문헌 및 기술 출처 (References)
- MobileNets: Efficient Convolutional Neural Networks for Mobile Vision Applications (arXiv:1704.04861)
- Depthwise Separable Convolution의 기본 원리와 표준 Conv 대비 연산량($1/N + 1/D_k^2$) 절감 메커니즘을 규명한 논문입니다.
- MobileNetV2: Inverted Residuals and Linear Bottlenecks (arXiv:1801.04381)
- 역잔차 구조(Narrow-Wide-Narrow), 확장 계수($t=6$), 그리고 저차원 정보 손실을 방지하는 Linear Bottleneck을 제안한 논문입니다.
- Distilling the Knowledge in a Neural Network (arXiv:1503.02531)
- 제프리 힌튼(Geoffrey Hinton) 교수 연구팀의 지식 증류(Knowledge Distillation) 원천 논문으로, Soft Target Loss 개념을 정립했습니다.
- SegFormer: Simple and Efficient Design for Semantic Segmentation with Transformers (arXiv:2105.15203)
- 자율주행 세그멘테이션에서 위치 임베딩 없이 효율적인 선형 어텐션(Attention Optimization)을 구현한 경량 트랜스포머 아키텍처 논문입니다.
- A novel focal Tversky loss function with improved Attention U-Net (arXiv:1810.07842)
- 극심한 클래스 불균형 및 미탐지(False Negative)에 비대칭 페널티를 부여하는 손실 함수 연구입니다.
공식 기술 문서 및 가속 엔진 (Official Documentation)
- NVIDIA TensorRT Developer Guide
- GPU 엣지 디바이스(Jetson 등) 환경에서 FP16/INT8 양자화, 커널 자동 튜닝 및 레이어 융합을 통한 실시간 추론 최적화 기술 가이드입니다.
- TensorFlow Lite (TFLite) 8-bit Quantization Specification
- 모바일 및 임베디드 CPU 환경에서 가중치와 연산을 INT8로 양자화하여 메모리 대역폭을 절감하는 표준 스펙 문서입니다.
- PyTorch Pruning Tutorial
- 본문 실습에 활용된
torch.nn.utils.prune모듈 기반 가중치 가지치기 구현 공식입니다.
- 본문 실습에 활용된