자율주행에서 ‘컴퓨터 비전’이란?
이전편은 기본적인 자율주행 차량이 왜 필요한지를 알아보았습니다. 안전하게 목적지까지 도달하려면 도로 위의 환경을 사람처럼 시각적으로 인지하고 즉각적인 판단을 내려야 합니다. 4륜 자동차는 안전벨트와 차체 구조 덕분에 자율주행 시스템과 급제동 알고리즘을 공격적으로 탑재할 수 있습니다. 컴퓨터 비전의 모든 기초는 바로 카메라 기반의 정밀한 시각 인지에서 시작됩니다.
컴퓨터 비전이 이미지를 해석하는 원리
컴퓨터에게 이미지란 단순한 사진이 아니라 형태의 3차원 숫자 행렬(Tensor)에 불과합니다. 과거의 고전 컴퓨터 비전은 개발자가 수학 공식을 세워 사람이 직접 정의한 특징(Hand-crafted Feature)을 추출했습니다:
- 경계선 (Edge): 픽셀 간 밝기 차이(미분)가 급격한 곳을 찾는 Canny Edge Detector 등
- 모서리 (Corner): 모든 방향으로 미분 값이 크게 변하는 지점을 찾는 Harris Corner Detector 등
- 질감 (Texture): 주변 픽셀과의 대소 관계를 2진 패턴으로 통계화하는 LBP(Local Binary Pattern) 등
하지만 컴퓨터 비전은 이러한 고전 규칙 기반 방식은 야간 주행, 비나 눈으로 인한 빛 번짐, 안개와 같은 급격한 조명 및 기상 변화에 대응하지 못하고 쉽게 무너졌습니다.
이를 극복하기 위해 등장한 것이 바로 빅데이터(Big Data), GPU 컴퓨팅 파워, 역전파 알고리즘(Backpropagation)에 기반한 CNN(합성곱 신경망) 딥러닝입니다. 딥러닝은 모델 스스로 수만 장의 데이터를 분석해 악천후 속에서도 변하지 않는 강건한(Robust) 특징을 계층적으로 학습합니다.
컴퓨터 비전의 이해 3단계: 분류 vs 탐지 vs 분할
컴퓨터 비전이 발전하면서 장면을 파악하는 수준은 ‘단순 인식(Recognition)’에서 ‘입체적 이해(Understanding)’로 진화했습니다.
| 인식: Recognition | 탐지: Detection | 이해: Understanding |
| 이미지에 무엇(What)이 있는가? (Classification) | 무엇(What)이 어디에(Where) 있는가? (Bounding Box) | 무엇이 어디에, 어떤 모양(Shape)으로 존재하는가? (Segmentation) |
단순 Bounding Box 방식은 사각형 내부의 불필요한 배경까지 포함하므로, 컴퓨터 비전의 차량이 코너를 돌거나 곡선 가드레일 옆을 지날 때 정밀한 충돌 회피 궤적을 그리기 어렵습니다. 따라서 컴퓨터 비전의 모든 픽셀마다 정체성을 부여하는 조밀한 예측(Dense Prediction), 즉 세그멘테이션(Segmentation)이 필수적입니다.
세그멘테이션의 3가지 유형
컴퓨터 비전의 데이터 파이프라인에서 풀고자 하는 문제에 따라 세그멘테이션은 3가지로 나뉩니다.
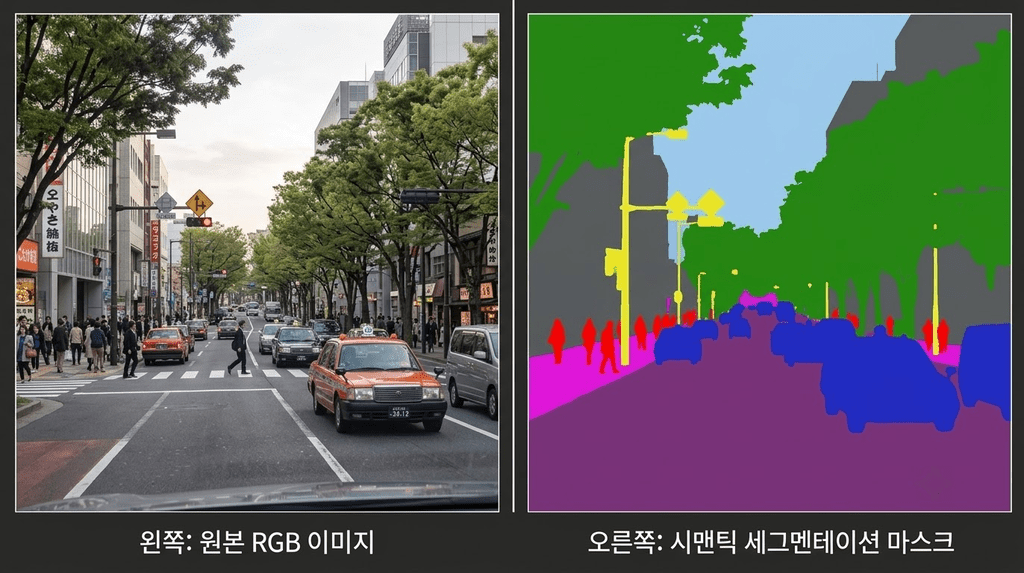
- 시맨틱 세그멘테이션 (Semantic Segmentation):
- 픽셀의 의미(클래스)만을 분류합니다. 앞서가는 차와 옆 차가 붙어 있으면 컴퓨터 비전이 하나의 거대한 ‘자동차 덩어리’로 인식합니다.
- 역할: 도로, 인도, 하늘, 건물처럼 형태가 고정되지 않고 넓게 펼쳐진 배경(Stuff)을 분할해 ‘내가 달릴 수 있는 도로(주행 가능 영역)’를 파악하는 데 최적입니다.
- 인스턴스 세그멘테이션 (Instance Segmentation):
- 도로와 하늘 같은 배경은 배제하고, 셀 수 있는 사물(Things) 각각에 고유 ID를 부여해 분할합니다.
- 역할: 보행자 1, 보행자 2, 차량 A, 차량 B를 개별 분리하여 동적 객체의 이동 궤적을 개별 추적(Tracking)할 때 사용됩니다.
- 파놉틱 세그멘테이션 (Panoptic Segmentation):
- 배경(Stuff)을 처리하는 Semantic 방식과 개별 사물(Things)을 처리하는 Instance 방식을 하나로 통합한 궁극의 분할 기술입니다.
- 역할: 도심 교차로처럼 복잡한 지형지물과 다수의 차량/보행자가 뒤섞인 환경을 단일 모델로 완벽하게 인식합니다.
컴퓨터 비전의 핵심 모델 아키텍처 구현
U-Net: 정밀 복원과 스킵 커넥션(Skip Connection)
2015년 제안된 컴퓨터 비전의 U-Net은 저수준 특징(위치, 모서리 정보)을 압축하는 인코더(Encoder)와 이를 원래 크기로 되돌리는 디코더(Decoder)를 대칭 구조로 연결했습니다. 인코더의 특징 맵을 디코더로 직접 건네주는 스킵 커넥션을 도입하여 다운샘플링 과정에서 손실된 위치 정보(Spatial Information)를 복원해냅니다.
import torch
import torch.nn as nn
import torch.nn.functional as F

class ConvBlock(nn.Module):
    """
    [기본 합성곱 블록]
    Conv -> BatchNorm -> ReLU 2회 반복 구조
    - BatchNorm이 뒤따르므로 Conv 계층의 bias는 False로 설정해 파라미터 낭비 방지
    """
    def __init__(self, in_channels, out_channels):
        super().__init__()
        self.block = nn.Sequential(
            # 커널 3x3, 패딩 1로 설정하여 입력과 출력의 가로/세로 해상도 유지
            nn.Conv2d(in_channels, out_channels, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True),
            nn.Conv2d(out_channels, out_channels, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True)
        )

    def forward(self, x):
        return self.block(x)


class Encoder(nn.Module):
    """
    [수축 경로 (Contracting Path)]
    해상도를 1/2로 줄여가며 의미론적(Semantic) 정보를 압축
    각 레벨의 특징 맵(e1~e4)은 스킵 커넥션으로 전달됨
    """
    def __init__(self, in_channels=3):
        super().__init__()
        self.enc1 = ConvBlock(in_channels, 64)   # H x W
        self.enc2 = ConvBlock(64, 128)           # H/2 x W/2
        self.enc3 = ConvBlock(128, 256)          # H/4 x W/4
        self.enc4 = ConvBlock(256, 512)          # H/8 x W/8
        self.pool = nn.MaxPool2d(kernel_size=2, stride=2)

    def forward(self, x):
        e1 = self.enc1(x)
        e2 = self.enc2(self.pool(e1))
        e3 = self.enc3(self.pool(e2))
        e4 = self.enc4(self.pool(e3))
        return e1, e2, e3, e4


class UpBlock(nn.Module):
    """
    [업샘플링 & 스킵 커넥션 모듈]
    전치 합성곱(ConvTranspose2d)으로 해상도를 2배 키운 후 인코더 특징 맵과 채널 결합(Concat)
    """
    def __init__(self, in_channels, out_channels):
        super().__init__()
        self.up = nn.ConvTranspose2d(in_channels, in_channels // 2, kernel_size=2, stride=2)
        self.conv = ConvBlock(in_channels, out_channels)

    def forward(self, x, skip):
        x = self.up(x)

        # [안전 장치] 홀수 해상도 입력 등으로 인한 1픽셀 크기 불일치 보정 (Padding)
        diff_y = skip.size(2) - x.size(2)
        diff_x = skip.size(3) - x.size(3)
        if diff_y != 0 or diff_x != 0:
            x = F.pad(x, [diff_x // 2, diff_x - diff_x // 2,
                          diff_y // 2, diff_y - diff_y // 2])

        # 채널 축(dim=1) 기준으로 Concat 후 합성곱 통과
        x = torch.cat([x, skip], dim=1)
        return self.conv(x)


class UNet(nn.Module):
    """
    [U-Net 통합 아키텍처]
    """
    def __init__(self, in_channels=3, num_classes=2):
        super().__init__()
        self.encoder = Encoder(in_channels=in_channels)

        # 바텀넥: 가장 깊은 계층으로 고수준 컨텍스트 정보 응축 (H/16 x W/16)
        self.bottleneck = ConvBlock(512, 1024)
        self.pool = nn.MaxPool2d(kernel_size=2, stride=2)

        # 확장 경로 (Expansive Path): 해상도 복원
        self.up4 = UpBlock(1024, 512)
        self.up3 = UpBlock(512, 256)
        self.up2 = UpBlock(256, 128)
        self.up1 = UpBlock(128, 64)

        # 최종 분류 헤드: 1x1 Conv를 통해 클래스 수만큼의 로짓(Logit) 출력
        self.head = nn.Conv2d(64, num_classes, kernel_size=1)

    def forward(self, x):
        # 1. 인코더 단계
        e1, e2, e3, e4 = self.encoder(x)

        # 2. 바텀넥 단계
        b = self.bottleneck(self.pool(e4))

        # 3. 디코더 단계 (스킵 커넥션 순차 결합)
        d4 = self.up4(b, e4)
        d3 = self.up3(d4, e3)
        d2 = self.up2(d3, e2)
        d1 = self.up1(d2, e1)

        # 4. 최종 예측 마스크 생성 (입력 해상도와 동일)
return self.head(d1)DeepLabv3+: 다중 스케일 맥락 파악을 위한 ASPP
구글의 DeepLabv3+는 컴퓨터 비전의 필터 사이에 간격을 띄워 해상도 손실 없이 수용 영역(Receptive Field)을 넓히는 Atrous(Dilated) Convolution을 핵심으로 사용합니다. 다양한 팽창률을 적용해 크고 작은 사물을 동시에 포착하는 ASPP(Atrous Spatial Pyramid Pooling) 기법으로 CNN 기반 시맨틱 분할의 정점을 찍었습니다.
import torch
import torch.nn as nn
import torch.nn.functional as F
import torchvision.models as models

class ASPP(nn.Module):
    """
    [Atrous Spatial Pyramid Pooling]
    다양한 팽창률(Dilation rate)의 Atrous Conv를 병렬 적용하여 다중 스케일 맥락 정보 포착
    """
    def __init__(self, in_channels, out_channels=256, atrous_rates=[6, 12, 18]):
        super().__init__()
        # 1. 1x1 Conv (국소 영역 특징)
        self.b1 = nn.Sequential(
            nn.Conv2d(in_channels, out_channels, kernel_size=1, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True)
        )
        # 2~4. 3x3 Atrous Conv (수용 영역 확장 특징)
        # padding=rate로 설정하여 dilation 적용 시에도 출력 해상도 유지
        self.b2 = nn.Sequential(
            nn.Conv2d(in_channels, out_channels, kernel_size=3, padding=atrous_rates[0], dilation=atrous_rates[0], bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True)
        )
        self.b3 = nn.Sequential(
            nn.Conv2d(in_channels, out_channels, kernel_size=3, padding=atrous_rates[1], dilation=atrous_rates[1], bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True)
        )
        self.b4 = nn.Sequential(
            nn.Conv2d(in_channels, out_channels, kernel_size=3, padding=atrous_rates[2], dilation=atrous_rates[2], bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True)
        )
        # 5. Image Pooling (전역 컨텍스트 정보 요약)
        self.b5 = nn.Sequential(
            nn.AdaptiveAvgPool2d((1, 1)),
            nn.Conv2d(in_channels, out_channels, kernel_size=1, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True)
        )

        # 5개 갈래의 피처 결합 (256 * 5 -> 256)
        self.project = nn.Sequential(
            nn.Conv2d(out_channels * 5, out_channels, kernel_size=1, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True),
            nn.Dropout(0.5)
        )

    def forward(self, x):
        h, w = x.shape[2], x.shape[3]
        res1 = self.b1(x)
        res2 = self.b2(x)
        res3 = self.b3(x)
        res4 = self.b4(x)
        # Image Pooling 브랜치는 1x1이므로 기존 해상도(h, w)로 양선형 보간 복원
        res5 = F.interpolate(self.b5(x), size=(h, w), mode='bilinear', align_corners=False)

        # 채널 결합 후 프로젝션
        return self.project(torch.cat([res1, res2, res3, res4, res5], dim=1))


class ResNetBackbone(nn.Module):
    """
    [ResNet 백본 래퍼]
    사전 학습된 ResNet50에서 저수준(Low-level) 및 고수준(High-level) 피처를 실제 추출
    """
    def __init__(self):
        super().__init__()
        resnet = models.resnet50(weights=models.ResNet50_Weights.DEFAULT)

        # Layer 1까지: H/4 해상도 (Low-level feature 추출용, 채널: 256)
        self.low_level_layers = nn.Sequential(
            resnet.conv1,
            resnet.bn1,
            resnet.relu,
            resnet.maxpool,
            resnet.layer1
        )
        # Layer 2 ~ Layer 4: H/16 해상도 (High-level feature 추출용, 채널: 2048)
        self.high_level_layers = nn.Sequential(
            resnet.layer2,
            resnet.layer3,
            resnet.layer4
        )

    def forward(self, x):
        low_feat = self.low_level_layers(x)    # [B, 256, H/4, W/4]
        high_feat = self.high_level_layers(low_feat) # [B, 2048, H/16, W/16] (단순화된 형태)
        return low_feat, high_feat


class DeepLabV3Plus(nn.Module):
    """
    [DeepLabv3+ 통합 아키텍처]
    Encoder: 백본 + ASPP (맥락 정보 캡처)
    Decoder: 저수준 피처 채널 축소 후 ASPP 출력과 융합하여 세부 경계 복원
    """
    def __init__(self, num_classes=2):
        super().__init__()
        self.backbone = ResNetBackbone()
        self.aspp = ASPP(in_channels=2048, out_channels=256)

        # 저수준 피처는 채널이 너무 크면 고수준 정보가 묻히므로 48채널로 압축
        self.reduce_low_level = nn.Sequential(
            nn.Conv2d(256, 48, kernel_size=1, bias=False),
            nn.BatchNorm2d(48),
            nn.ReLU(inplace=True)
        )

        # 디코더: ASPP 피처(256) + 압축된 저수준 피처(48) = 304채널
        self.decoder = nn.Sequential(
            nn.Conv2d(304, 256, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(256),
            nn.ReLU(inplace=True),
            nn.Conv2d(256, 256, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(256),
            nn.ReLU(inplace=True),
            nn.Conv2d(256, num_classes, kernel_size=1)
        )

    def forward(self, x):
        input_size = x.size()[2:] # 원본 이미지 (H, W)

        # 1. 백본을 통한 실제 피처 추출 (그래디언트 보존)
        low_feat, high_feat = self.backbone(x)

        # 2. 고수준 피처를 ASPP에 통과시켜 전역 맥락 파악
        aspp_out = self.aspp(high_feat)

        # 3. 저수준 피처 채널 축소 (256 -> 48)
        low_feat = self.reduce_low_level(low_feat)

        # 4. ASPP 출력을 저수준 피처 크기(H/4, W/4)로 4배 업샘플링
        aspp_up = F.interpolate(aspp_out, size=low_feat.size()[2:], mode='bilinear', align_corners=False)

        # 5. 피처 결합 후 정밀 경계 복원 (Decoder)
        out = self.decoder(torch.cat([aspp_up, low_feat], dim=1))

        # 6. 최종 마스크를 원본 입력 이미지 크기(H, W)로 복원 (align_corners 일관성 유지)
return F.interpolate(out, size=input_size, mode='bilinear', align_corners=False)컴퓨터 비전 트랜스포머의 등장과 최신 모델 비교
DeepLabv3+ 이후 학계는 합성곱(CNN)의 국소적인 한계를 벗어나 컴퓨터 비전 트랜스포머(Vision Transformer) 기반 모델로 전환되었습니다.
- SegFormer: 포지셔널 인코딩을 생략하고 경량 MLP 디코더를 붙여 연산량을 대폭 낮춘 모델로, 임베디드 자율주행 보드에 최적화되어 있습니다.
- Mask2Former: 픽셀을 개별 분류하지 않고 마스크 주의집중(Masked Attention)으로 객체 단위 마스크를 추출합니다. DeepLabv3+에서 번지던 보행자 팔다리와 얇은 표지판 지주를 오차 없이 정밀하게 분할합니다.
- SAM (Segment Anything Model): 메타(Meta)가 발표한 초거대 파운데이션 모델로, 점이나 박스 프롬프트 하나로 미학습 객체까지 잘라내는 제로샷 성능을 보여주며 자동 라벨링 도구의 표준이 되었습니다.
| 모델 | 기반 기술 | 주요 메커니즘 | 자율주행 적합도 |
| FCM | 클러스터링 | 픽셀 소속 확률 기반 비지도 학습 | 낮음 (배경 노이즈 취약) |
| U-Net | CNN | U자형 인코더-디코더 + 스킵 커넥션 | 보통 (의료 및 정밀 엣지용) |
| DeepLabv3+ | CNN | 확장 합성곱(Atrous Conv) + ASPP 모듈 | 높음 (전통적 벤치마크 기준) |
| SegFormer | Transformer | 계층형 인코더 + 올인원 경량 MLP 디코더 | 매우 높음 (실시간 처리 최적화) |
| Mask2Former | Transformer | 마스크 어텐션 기반 3종 세그멘테이션 통합 | 최상 (정확도 기준 현존 SOTA) |
데이터 엔지니어링: 어노테이션, 증강 및 엣지 케이스
컴퓨터 비전의 고성능 모델을 완성하기 위해서는 컴퓨터 비전의 모델 아키텍처뿐만 아니라 고품질 데이터 파이프라인 구축이 필수적입니다.
어노테이션 포맷과 마스크(Mask)
- 어노테이션(Annotation): 단순 클래스 태깅을 넘어 객체의 폴리곤 좌표, 조명 상태, 가려짐 여부(Occlusion) 등을 JSON/XML 파일로 구조화하여 저장합니다.
- 인덱스 마스크 (Index Mask): 배경=0, 도로=1, 차량=2 등 정수 번호로 이루어져 인공지능이 계산 및 역전파 손실(Loss)을 계산하는 정답(GT) 텐서입니다.
- 컬러 마스크 (Color/Palette Mask): 모델의 예측 결과를 개발자가 육안으로 확인하기 위해 색상 팔레트를 입힌 시각화 이미지입니다.
데이터 증강(Augmentation) 규칙
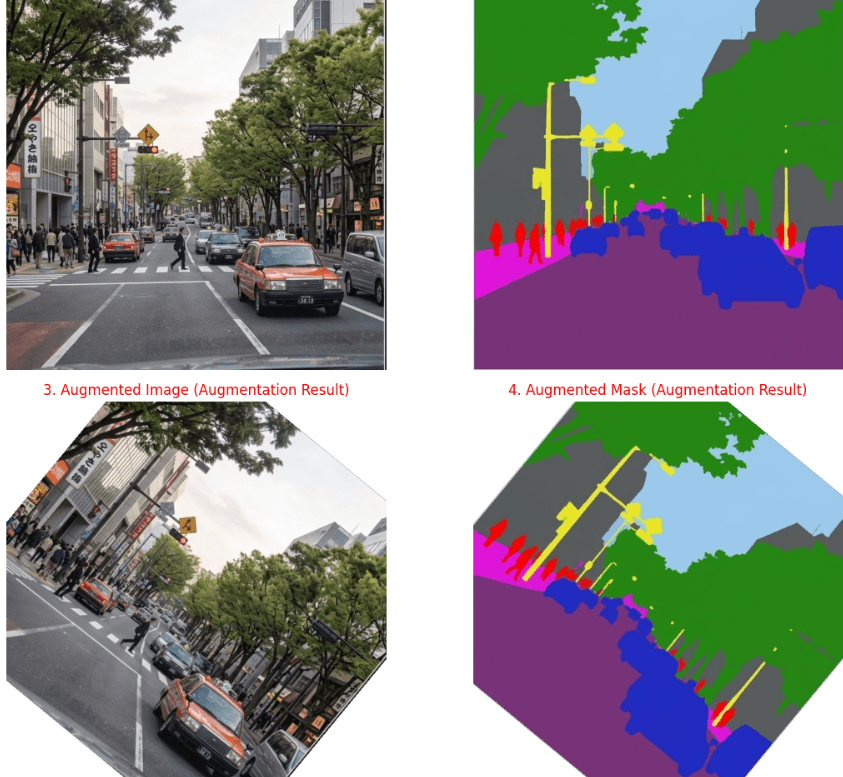
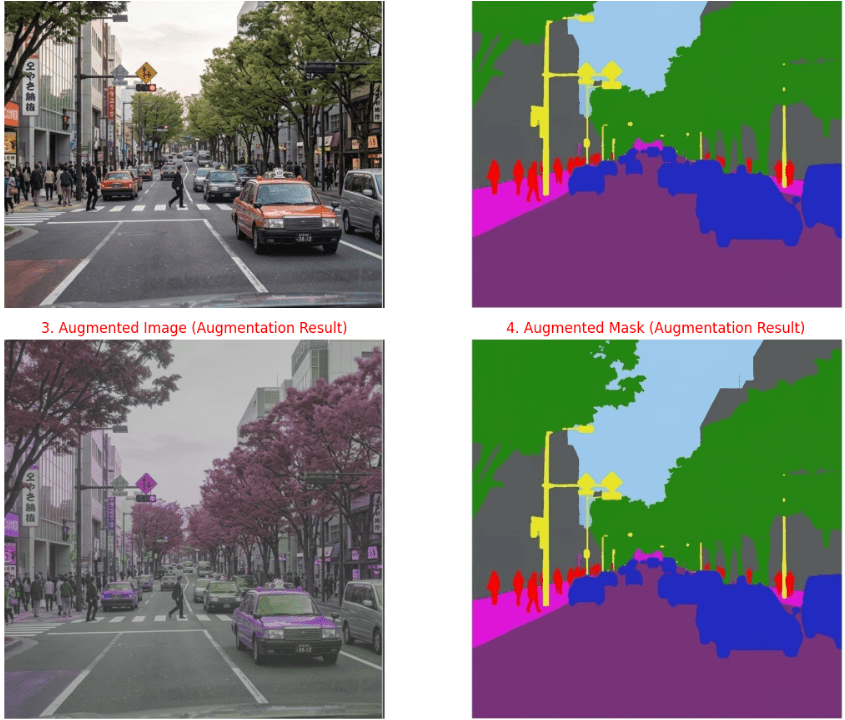
컴퓨터 비전 한정된 데이터의 경험 폭을 넓혀 일반화(Generalization) 성능을 높이려면 데이터 증강이 필수입니다. ai로 생성된 이미지를 가져왔습니다!
- 기하학적 변환 (Geometric): 좌우 반전(Horizontal Flip), 회전(Rotation), 크롭(Crop & Resize) 등.
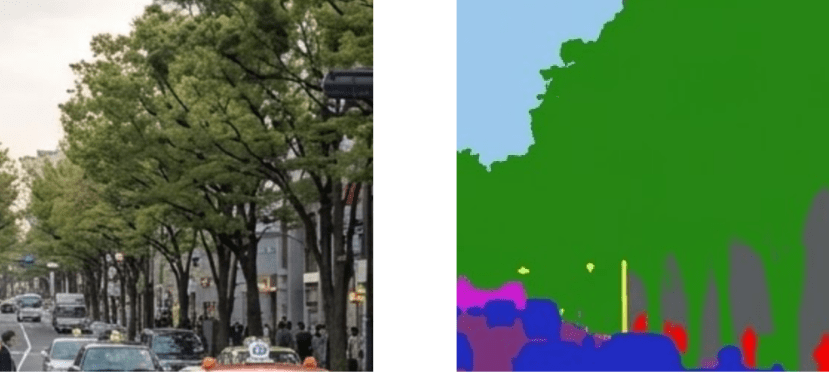
- 광학적 변환 (Photometric): 밝기/대비 조절, 컬러 지터링(Color Jittering), 가우시안 블러/노이즈 등.
엣지 케이스(Edge Case)와 코너 케이스(Corner Case) 극복
컴퓨터 비전의 단일 변수의 극단적 상황인 엣지 케이스(폭우, 도로 위 낙하물)와 복합 변수가 얽힌 코너 케이스(안개 낀 야간에 역주행하는 자전거)는 도로 위에서 치명적인 사고를 유발합니다.
- Targeted Mining: 실제 주행 중 모델의 예측 신뢰도(Confidence)가 낮은 불확실한 데이터만 선별 수집
- Synthetic Data: CARLA 같은 시뮬레이터를 활용해 위험천만한 가상 충돌 시나리오를 무한 복제 생성
- OOD(Out-Of-Distribution) Detection: 학습 데이터셋에 없던 전혀 새로운 미지의 물체를 마주했을 때 억지로 분류하지 않고 ‘미확인 위험물’로 인지시켜 급제동 오류를 방지
갑자기 궁금해짐. (FAQ)
Q1. 왜 오토바이에는 자동차처럼 완전 자율주행 분할 시스템이 적용되지 않나요?
오토바이는 2륜 구조 특성상 회전 시 라이더의 체중 이동과 뱅킹 각도 제어가 물리적으로 매우 까다롭습니다. 또한 비상 상황 시 AI가 강하게 회피 기동이나 풀 브레이킹을 실행하면 라이더가 외부로 튕겨 나갈 위험이 있고, 센서와 고성능 컴퓨팅 장비를 실을 배터리 용량 및 공간이 부족하기 때문입니다.
Q2. U-Net과 DeepLabv3+의 디코더 복원 방식은 어떻게 다른가요?
U-Net은 채널을 맞춘 뒤 인코더의 저수준 특징 맵을 단순히 옆으로 이어 붙이는(Concat) 스킵 커넥션 방식을 사용합니다. 반면 DeepLabv3+는 고수준 특징을 ASPP로 넓게 추출한 뒤 4배 업샘플링하고, 인코더 앞단의 얕은 특징을 1×1 Conv로 48채널까지 압축해 결합하는 계층적 융합 방식을 취합니다.
Q3. 실무 자율주행 프로젝트에서 DeepLabv3+ 대신 Mask2Former를 고려해야 하는 이유는 무엇인가요?
DeepLabv3+는 연산이 안정적이지만 픽셀 단위로만 판단하므로 얇은 기둥이나 겹쳐 있는 보행자 경계를 뭉개는 경향이 있습니다. 반면 Mask2Former는 어텐션 메커니즘을 통해 객체 단위 마스크를 직접 예측하므로 겹친 사물의 엣지를 정밀하게 따내어 훨씬 높은 안전 마진을 확보할 수 있습니다.
외부 출처 및 레퍼런스 (References)
- 공공 데이터셋 출처
- BDD100K (Berkeley DeepDrive 100K): UC 버클리에서 공개한 자율주행 컴퓨터 비전 대규모 벤치마크 데이터셋 (https://bdd-data.berkeley.edu)
- AI Hub: 과학기술정보통신부 및 한국지능정보사회진흥원(NIA) 주관 컴퓨터 비전 ‘승용 자율주행차 주간 도심도로 데이터셋’ (https://www.aihub.or.kr)
- 핵심 학술 논문
- Ronneberger et al., “U-Net: Convolutional Networks for Biomedical Image Segmentation”, MICCAI 2015.
- Chen et al., “Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation” (DeepLabv3+), ECCV 2018.
- Xie et al., “SegFormer: Simple and Efficient Design for Semantic Segmentation with Transformers”, NeurIPS 2021.
- Cheng et al., “Masked-attention Mask Transformer for Universal Image Segmentation” (Mask2Former), CVPR 2022.
- Kirillov et al., “Segment Anything” (SAM), ICCV 2023.
우와 멋졍 ❤️❤️