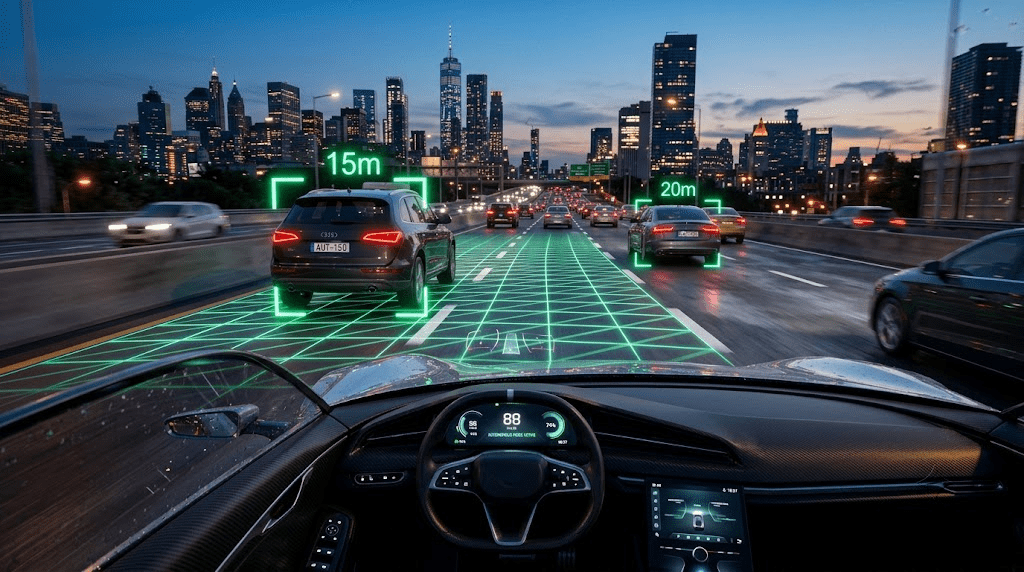
안녕하세요! 지난 파이토치로 만들어본 내용에 이어서 이번에는 최근 자율주행 기술이 발전하면서 가장 뜨거운 감자로 떠오른 것은 바로 센서의 선택입니다. 수천만 원에 달하는 라이다(LiDAR) 센서 없이, 오직 카메라만으로 완벽한 자율주행을 구현하려는 시도들이 이어지고 있습니다. 그렇다면 평면적인 2D 이미지만을 받아들이는 카메라는 도대체 어떻게 전방 차량과의 3차원 거리를 알아내는 것일까요?
오늘은 최신 모빌리티 기술의 핵심인 자율주행 카메라 거리 측정의 작동 원리와 그 속에 숨겨진 기하학적, 인공지능적 비밀을 단계별로 완벽하게 파헤쳐 보겠습니다.
자율주행 카메라 거리 측정의 한계: 왜 ‘분할(Segmentation)’만으로는 부족할까?
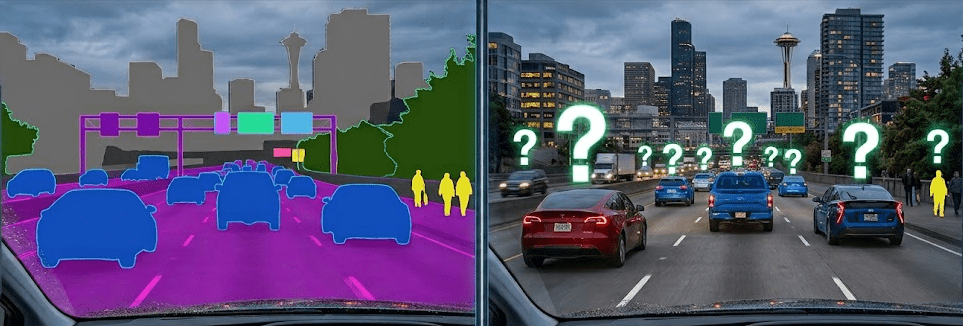
자율주행 시스템이 도로를 이해하는 첫 번째 단계는 화면 속 픽셀들이 각각 무엇을 의미하는지 분류하는 의미론적 분할(Semantic Segmentation)입니다. 이 기술을 통해 카메라는 도로, 차선, 보행자, 건물 등을 색상별로 완벽하게 구분해 냅니다. 전체 픽셀 비율을 분석하여 현재 주행 환경이 빌딩이 많은 도심인지, 나무가 많은 교외인지 시나리오 맥락까지 파악할 수 있습니다.
하지만 이 분할 기술만으로는 완벽한 자율주행 카메라 거리 측정을 구현할 수 없습니다. Semantic Segmentation은 눈앞에 있는 물체가 ‘무엇(What)’인지는 정확히 알지만, 나와 ‘얼마나(How far)’ 떨어져 있는지는 전혀 알지 못하기 때문입니다.
- 앞차가 나와 20m 거리에 있다면 즉시 감속을 준비해야 합니다.
- 거리가 15m로 줄어들면 실제 감속을 시작해야 합니다.
- 거리가 10m 이내가 되면 충돌을 막기 위해 차량을 완전히 정지시켜야 합니다.
평면적인 이미지 인식만으로는 이러한 물리적 제어(브레이크)를 위한 깊이 정보를 알 수 없으며, 심지어 멀리 있는 여러 대의 차량이 같은 색상 덩어리로 뭉쳐 보여 개별 차량을 구분하는 것조차 불가능해집니다. 따라서 단순한 인식을 넘어 3차원 공간의 깊이를 추정하는 과정이 반드시 필요합니다.
핀홀 카메라 모델: 2D 이미지에서 3D 거리를 추출하는 마법
카메라가 거리를 모르는 근본적인 이유는 3차원의 현실 세계가 2차원 이미지 평면으로 투영되면서 깊이(Depth) 정보가 완전히 제거되기 때문입니다. 하지만 기하학적 원리인 ‘핀홀 카메라 모델(Pinhole Camera Model)’을 활용하면 사라진 거리를 수학적으로 다시 찾아낼 수 있습니다.
이 모델은 빛이 아주 작은 구멍(핀홀)을 통과해 뒤쪽 이미지 센서(망막)에 상이 맺히는 원리를 설명합니다. 여기서 삼각형의 닮음비를 이용한 매우 직관적이고 강력한 자율주행 카메라 거리 측정 공식이 탄생합니다.
- 카메라 렌즈 중심에서 이미지 평면까지의 물리적 거리를 초점 거리(f)라고 합니다.
- 실제 세상에 존재하는 앞차의 높이나 폭을 실제 크기(Y)라고 합니다.
- 카메라 센서(사진)에 픽셀 단위로 찍힌 앞차의 크기를 사진 속 크기(y)라고 합니다.
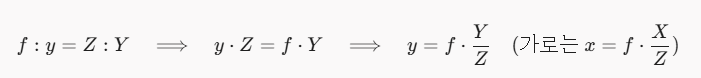
이 세 가지 요소를 삼각형의 닮음비에 대입하면 우리가 그토록 원하던 전방 물체까지의 실제 거리(Z)를 도출할 수 있습니다.
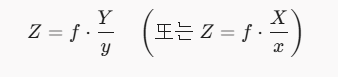
즉, 카메라의 고유 스펙인 초점 거리(f)와 일반적인 차량의 실제 규격(Y)을 미리 알고 있다면, 센서에 맺힌 픽셀 크기(y)만 계산하여 단 한 장의 사진만으로도 앞차가 몇 미터 앞에 있는지 역산해 낼 수 있는 것입니다.
스케일의 모호성: 상대적 거리와 절대적 거리의 딜레마
최근에는 인공지능이 핀홀 모델을 넘어 단 한 대의 카메라만으로 깊이를 추정하는 단안 깊이 추정(Monocular Depth Estimation) 기술을 활용합니다. 하지만 여기서 자율주행 카메라 거리 측정이 직면하는 가장 큰 난관이 발생하는데, 바로 ‘스케일의 모호성(Scale Ambiguity)’입니다.
- 비율의 함정: 거대하고 멀리 있는 화물차와 작고 가까이 있는 장난감 차가 카메라 화면상에서는 똑같이 50픽셀의 크기로 보일 수 있습니다.
- 부적정 문제(ill-posed problem): 두 물체의 크기(X)와 거리(Z)가 달라도 그 비율(X/Z)이 일치하면 사진에는 똑같이 나타나기 때문입니다.
- 치명적 오류: AI가 이 둘을 구분하지 못하고 작은 장애물을 멀리 있는 거대한 구조물로 착각할 경우, 주행 경로를 잘못 판단하여 제동 거리를 확보하지 못하는 끔찍한 사고로 이어집니다.
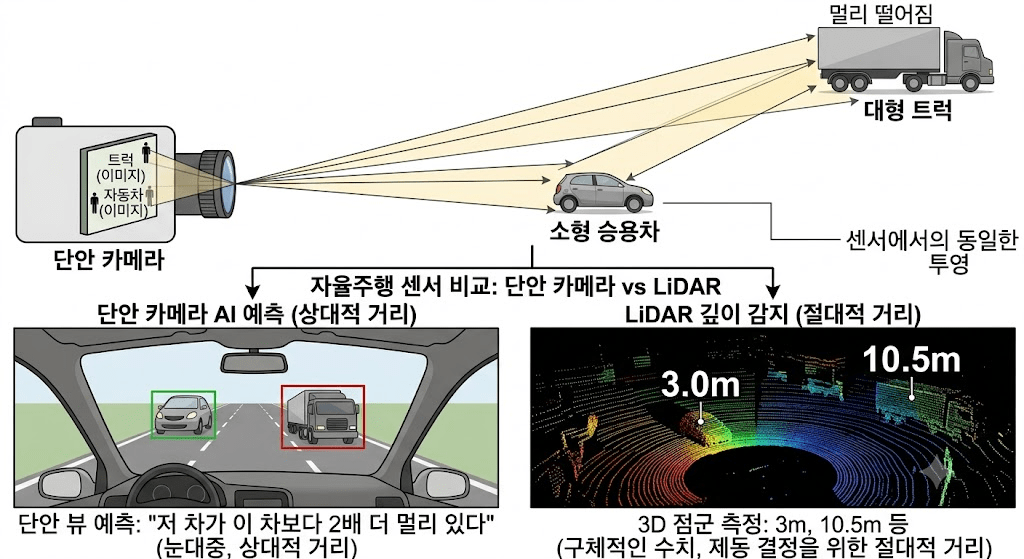
단안 카메라가 AI를 통해 예측하는 결과는 “저 차가 이 차보다 2배 더 멀리 있다”는 눈대중 형태의 상대적 거리일 뿐입니다. 자율주행차가 실제로 브레이크를 밟기 위해서는 라이다(LiDAR)처럼 3m, 10.5m 단위로 떨어지는 구체적인 수치, 즉 절대적 거리가 필요합니다.
자율주행 카메라 거리 측정의 완성
상대적 거리를 브레이크 제어가 가능한 절대적 거리(m)로 변환하기 위해 곱해주는 비례 상수를 바로 스케일 팩터(Scale Factor)라고 부릅니다. AI가 내놓은 상대적 수치(0~1)에 스케일 팩터를 곱해야만 비로소 현실의 물리적 거리가 산출됩니다.
사진 속 1픽셀이 현실의 몇 cm인지를 의미하는 이 기준점(스케일 복원)을 찾기 위해 현업에서는 다음과 같은 방법론을 사용합니다.
센서 퓨전 (Sensor Fusion): 카메라 한 대로는 불가능하므로 타 센서와 융합.
- LiDAR / Radar: 레이저나 전파를 쏴서 직접적인 물리적 거리 기준점을 획득.
- IMU (관성 센서): 지면으로부터의 카메라 설치 높이와 기울기를 측정해 기하학적으로 스케일을 계산.
소프트웨어 및 기하학 기반 복원:
- 지면 기하학: 카메라 설치 높이가 고정되어 있을 때 평평한 도로 바닥을 기준으로 스케일 산출 (연산 가벼움, 언덕/요철 시 오차).
- 물체 크기 활용: 도로 위 표준 규격 물체(예: 일반 승용차 규격)의 실제 크기를 사전 지식으로 두고 역산 (가려지거나 멀면 오차).
- 비디오 분석: 카메라가 주행 이동 중일 때 연속 프레임(모션/포즈)을 비교해 복원 (정차 시 스케일 소실)
결과적으로 안전하고 완벽한 자율주행 카메라 거리 측정은 카메라 하드웨어, 인공지능 모델의 상대적 깊이 추론, 그리고 스케일 팩터를 복원하는 치밀한 소프트웨어 로직(또는 센서 퓨전)이 결합된 종합 예술이라고 볼 수 있습니다.
자주 묻는 질문 (FAQ)
Q1. 카메라는 왜 한 장의 사진만으로 정확한 절대 거리(m)를 측정하기 어려운가요?
A. 3차원의 현실 세계가 2차원 이미지 센서 평면으로 투영(Projection)되면서 깊이(Depth) 차원의 축이 사라지기 때문입니다. 이로 인해 멀리 있는 큰 물체와 가까이 있는 작은 물체의 비율(X/Z)이 같으면 사진 속에 동일한 픽셀 크기로 찍히는 ‘스케일의 모호성(Scale Ambiguity)’이 발생합니다
Q2. 인공지능(AI) 기반 단안 깊이 추정(MDE)의 결과값은 바로 차량 제어에 쓸 수 없나요?
A. 단독으로는 불가능합니다. 딥러닝 모델이 카메라 한 대로 내놓는 결과는 “어떤 물체가 더 멀고 가까운지”를 나타내는 상대적 거리(Relative Distance, 0~1 값)이기 때문입니다. 실제 차량의 브레이크를 제어하려면 ‘스케일 팩터(Scale Factor)’를 곱해 현실의 물리적 단위인 미터(m)로 변환하는 스케일 복원 과정이 필수적입니다.
Q3. 스케일 팩터(Scale Factor)는 실제로 어떻게 복원하나요?
A. 크게 세 가지 방식을 활용합니다. 첫째, 라이다(LiDAR), 레이더(Radar), IMU(관성 센서)의 물리적 기준점을 엮는 센서 퓨전(Sensor Fusion) 방식, 둘째, 카메라의 설치 높이와 도로 바닥면을 활용하는 지면 기하학(Ground Geometry) 방식, 셋째, 도로 위 일반 승용차의 표준 크기(높이 약 1.5m 등)를 사전 지식으로 두고 핀홀 수식으로 역산하는 물체 규격 활용 방식이 있습니다.
Q4. 스테레오 카메라와 단안 카메라(Monocular) 깊이 추정의 결정적 차이는 무엇인가요?
A. ‘물리적인 자(Ruler)’의 유무 차이입니다. 스테레오 카메라는 좌우 렌즈 사이의 고정된 간격(Baseline, b)을 알고 있어 삼각측량 공식을 통해 절대적 거리를 즉각 계산합니다. 반면 단안 카메라는 물리적 기준선이 없어 AI 추론과 기하학적 보정 기법을 결합해 스케일을 복원해야 합니다.
참고 문헌 및 자료 출처 (References)
본 포스팅에서 다룬 자율주행 컴퓨터 비전 알고리즘, 카메라 기하학 및 깊이 추정 원리는 아래의 학술 연구 및 벤치마크 데이터를 기반으로 작성되었습니다.
- [카메라 기하학 / 핀홀 투영 모델]
- Richard Hartley & Andrew Zisserman, Multiple View Geometry in Computer Vision, Cambridge University Press.
- 내용: 핀홀 카메라 모델, 초점 거리, 3차원 월드 좌표계에서 2차원 이미지 평면으로의 투영 및 기하학적 닮음비 원리의 수학적 토대
- [비디오 기반 비지도 단안 깊이 추정 (SfM-Learner)]
- Tinghui Zhou et al., “Unsupervised Learning of Depth and Ego-Motion from Video”, CVPR 2017.
- 내용: 단일 카메라 연속 프레임에서 차량의 이동(Pose)과 깊이를 동시에 예측하며 학습하는 동영상 기반 MDE 핵심 알고리즘
- [스테레오 이미지 기반 깊이 추정 (Monodepth)]
- Clément Godard et al., “Digging Into Monocular Depth Estimation with Left-Right Consistency (Monodepth2)”, ICCV 2019.
- 내용: 좌우 카메라의 시차(Disparity) 및 기하학적 재합성을 이용해 카메라 한 대로도 정밀한 상대적/절대적 거리를 학습하는 구조
- [시맨틱 세그멘테이션 및 도심 주행 벤치마크]
- Marius Cordts et al., “The Cityscapes Dataset for Semantic Urban Scene Understanding”, CVPR 2016.
- Stephan R. Richter et al., “Playing for Data: Ground Truth from Computer Games (GTA5 Dataset)”, ECCV 2016.
- 내용: 자율주행 도로 환경의 객체 분할(도로, 차량, 보행자 등) 표준 라벨 매핑 및 학습 데이터셋 규격