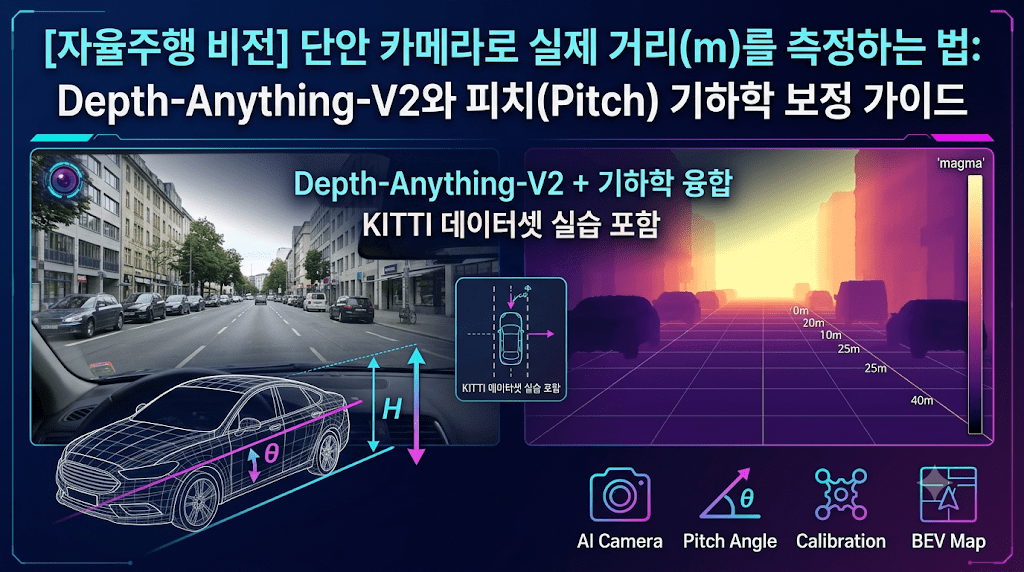
왜 자율주행은 단안 모노뎁스(Monocular Depth)에 집중하는가?
지난 시간 자율주행 인지(Perception) 시스템의 핵심 목표는 “내 차량 전방의 장애물이 정확히 몇 미터(m) 앞에 있는가”를 오차 없이 파악하는 것입니다. 전통적으로는 고가의 라이다(LiDAR)나 두 개의 렌즈를 사용하는 스테레오 카메라(Stereo Camera)를 통해 시차(Disparity) 기반의 삼각측량을 수행해 왔습니다.
하지만 라이다는 수천만 원을 호가하는 하드웨어 비용과 악천후(비, 눈, 안개) 시 난반사 문제가 있고, 스테레오 카메라는 주행 중 차체 진동으로 두 카메라 간의 정렬(Baseline)이 미세하게 틀어지는 기계적 한계가 존재합니다.
이로 인해 테슬라(Tesla)를 비롯한 주요 자율주행 연구진들은 단 한 대의 일반 RGB 카메라(Monocular Camera) 영상만으로 3차원 공간 깊이를 복원해내는 모노뎁스(Monocular Depth Estimation) 기술을 고도화하고 있습니다.
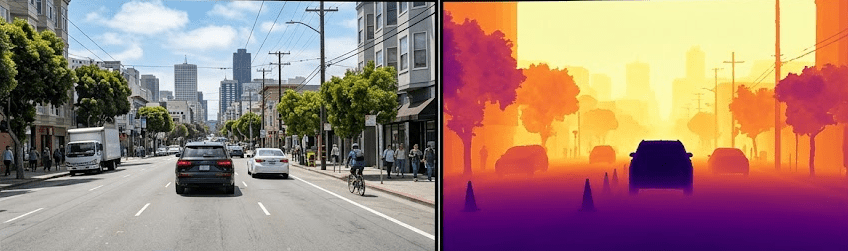
딥러닝 + 고전 기하학: AI 혼자서는 거리를 알 수 없다
AI 딥러닝 (Depth-Anything-V2)의 역할: “원근감을 기가 막히게 그리는 화가”
- AI는 사진을 보고 “무엇이 앞에 있고 무엇이 뒤에 있는지” 기가 막히게 구별합니다.
- 하지만 AI가 주는 결과물은 그냥 명암 차이(0~255)일 뿐입니다. 즉, “앞차가 뒤차보다 가깝다”는 건 알지만, 그 앞차가 진짜 10m 앞의 실제 자동차인지, 아니면 1m 바로 앞의 작은 미니카 장난감인지 물리적인 진짜 거리(미터)는 알지 못합니다.
고전 기하학 (지면 기하학)의 역할: “현실의 눈금을 그어주는 자(Ruler)”
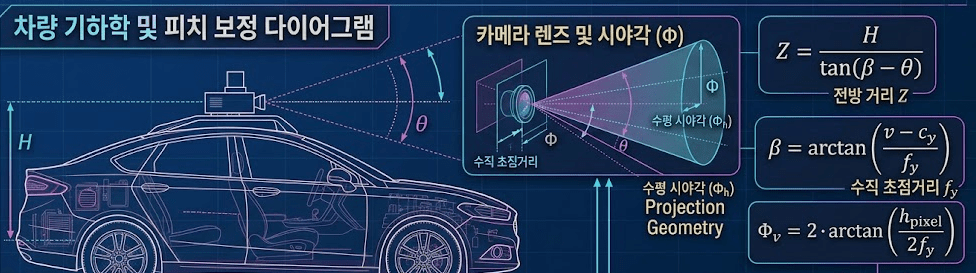
- “도로는 평평한 바닥이다”라는 상식을 바탕으로, 카메라의 렌즈 스펙과 카메라가 땅에서 몇 미터 높이에 달렸는지를 수학 공식에 넣습니다.
- 이렇게 해야 비로소 AI가 그린 그림 위에 “이 지점은 내 차에서 정확히 15.3미터 앞이다”라는 현실의 진짜 줄자를 가져다 댈 수 있습니다.
결국 “배경의 상대적 깊이 윤곽은 AI가 그리고, 현실의 절대 거리는 기하학 수식으로 계산하여 얹어주는 융합 파이프라인”이 필수적입니다.
지면 거리 공식과 피치(Pitch) 보정의 필요성
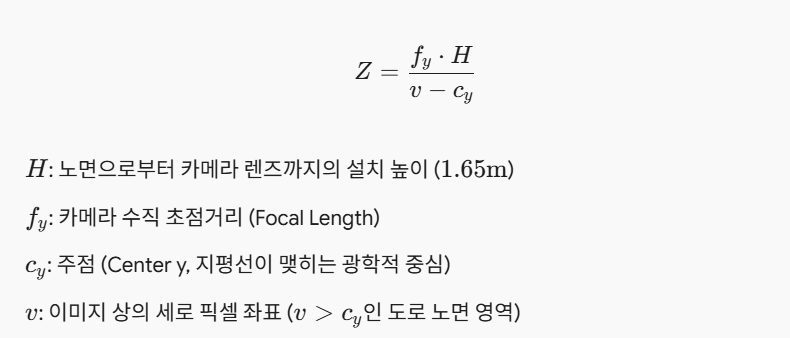
(1) 기본 지면 역투영 공식
카메라가 도로 지면과 완벽하게 수평을 유지하고 있다면, 이미지 세로 픽셀 좌표와 카메라 내부 파라미터를 통해 전방 거리를 바로 구할 수 있습니다.
(2) 차가 덜컹거릴 때 생기는 치명적 오차: Pitch
그러나 실제 주행 차량은 가속 시 차체가 뒤로 젖혀지고(Squat), 감속 시 앞으로 쏠리며(Dive), 요철을 넘을 때 끊임없이 위아래로 끄덕이는 피치(Pitch) 회전을 합니다.
카메라가 단 1º만 아래로 숙여져도 화면 속 도로 픽셀이 위로 밀려 올라가며, 계산식의 분모가 왜곡됩니다. 그 결과 앞차와의 실제 거리는 그대로인데 시스템은 “순식간에 15m에서 8m로 좁혀졌다”고 착각하여 급제동(유령 브레이크)을 밟는 대형 사고를 유발할 수 있습니다.
(3) OXTS 센서 데이터를 활용한 실시간 피치 보정
이를 방지하기 위해 차량의 IMU(관성측정센서)나 GPS가 포함된 OXTS 데이터에서 실시간 피치를 받아 수식의 분모를 보정합니다. 이는 카메라의 ‘디지털 손떨림 방지(EIS)’와 정확히 같은 원리입니다.
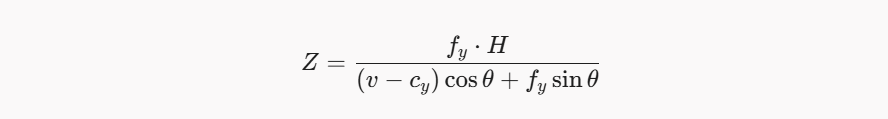
Depth-Anything-V2 + KITTI 피치 보정 파이프라인
다음은 구글 코랩(Google Colab) 환경에서 KITTI 데이터셋 연속 프레임과 OXTS 피치 각도를 연동하여, 흔들림 없이 안정적인 거리가 라벨링된 분석 GIF를 생성하는 완성형 파이썬 코드입니다.
Python
import os
import io
import cv2
import numpy as np
import matplotlib.pyplot as plt
from PIL import Image
from tqdm import tqdm
from transformers import pipeline

# 1. KITTI OXTS 파일에서 Pitch 각도(라디안) 파싱
def read_kitti_pitch(oxts_file):
    with open(oxts_file, 'r') as f:
        vals = f.readline().split()
    pitch = float(vals[4])  # 5번째 수치가 실시간 Pitch 각도
    return pitch

# 2. 피치 각도가 반영된 지면 거리 계산 함수
def get_ground_distance_with_pitch(height, calib_file, pitch):
    with open(calib_file, 'r') as f:
        lines = f.readlines()
        p2_line = [l for l in lines if 'P_rect_02' in l][0]
        p2_data = np.array(p2_line.split()[1:], dtype=np.float32)

    fy = p2_data[5]
    cy = p2_data[6]
    fx = p2_data[0]
    cx = p2_data[2]
    H = 1.65  # KITTI 기본 카메라 지면 높이 (m)

    v = np.arange(height)
    dist_to_ground = np.zeros_like(v, dtype=np.float32)

    # 피치 회전 보정 분모 적용
    denom = (v - cy) * np.cos(pitch) + fy * np.sin(pitch)
    mask = denom > 0
    dist_to_ground[mask] = (H * fy) / denom[mask]

    return dist_to_ground, fx, cx

# 3. 모노뎁스 추론 및 시각화 프레임 합성
def generate_pitch_compensated_gif(input_dir, oxts_dir, calib_file, save_path, target_xs):
    # GPU 가속(device=0) 활성화
    pipe = pipeline(
        task="depth-estimation",
        model="depth-anything/Depth-Anything-V2-Large-hf",
        device=0
    )

    fnames = sorted([
        f for f in os.listdir(input_dir)
        if f.endswith(('.png', '.jpg', '.jpeg')) and f.startswith('0000')
    ])

    gif_frames = []
    fig, ax = plt.subplots(1, 1, figsize=(12, 7))

    print(f"🚀 피치 보정 분석 GIF 생성 시작: 총 {len(fnames)} 프레임")

    for fname in tqdm(fnames):
        img_path = os.path.join(input_dir, fname)
        oxts_file = os.path.join(oxts_dir, fname.replace('.png', '.txt'))

        image = Image.open(img_path)
        w, h = image.size
        row_line = h - 50  # 분석할 전방 노면 가로 라인

        # 피치 읽기 및 기하학 거리 맵 계산
        pitch = read_kitti_pitch(oxts_file)
        distances, fx, cx = get_ground_distance_with_pitch(h, calib_file, pitch)

        # Depth-Anything-V2 추론 및 컬러맵 적용
        depth_out = pipe(image)["depth"]
        output_norm = np.array(depth_out)
        output_color = cv2.applyColorMap(output_norm, cv2.COLORMAP_MAGMA)

        ax.clear()
        ax.imshow(cv2.cvtColor(output_color, cv2.COLOR_BGR2RGB))
        ax.axhline(row_line, color='#C5CAE9', linestyle='--', linewidth=2)

        # 타깃 좌표별 유클리드 실측 직선거리(D) 계산 및 텍스트 렌더링
        for px in target_xs:
            ax.scatter(px, row_line, color='blue', s=90, zorder=3)

            Z = distances[row_line]        # 전방 수직 깊이
            X = (px - cx) * Z / fx         # 좌우 횡방향 편차
            D = np.sqrt(X**2 + Z**2)       # 대각선 실측 직선거리

            ax.text(
                px + 15, row_line, f"{D:.2f}m",
                color='white', fontsize=11, fontweight='bold',
                bbox=dict(facecolor='black', alpha=0.5, edgecolor='none', boxstyle='round,pad=0.2')
            )

        ax.set_title("Pitch-Compensated Ground Distance Tracking")
        ax.axis('off')
        plt.tight_layout()

        # 메모리 버퍼(io.BytesIO)를 통해 GIF 프레임 생성
        buf = io.BytesIO()
        fig.savefig(buf, format='png')
        buf.seek(0)
        gif_frames.append(Image.open(buf).copy())
        buf.close()

    plt.close(fig)

    # GIF 저장
    if gif_frames:
        gif_frames[0].save(
            save_path,
            save_all=True,
            append_images=gif_frames[1:],
            duration=1000 // 10,
            loop=0
        )
        print(f"✅ 저장 완료: {save_path}")
차세대 모노뎁스 트렌드: V2 그 이상을 향해
오늘 사용한 Depth-Anything-V2는 매우 간단하고 사용하기 좋지만, “상대적 원근감만 제공하므로 외부 수식 계산이 강제된다”는 태생적 한계가 있습니다.
그러나 최근 모노뎁스 분야는 상상을 뛰어넘는 속도로 진화하고 있습니다. 특히 캘리브레이션 없이도 0.3초 만에 직접 뽑아내는 Apple Depth Pro나 3D 공간을 통째로 복원하는 Depth Anything 3로 기술이 빠르게 고도화되고 있습니다.
- Apple Depth Pro (제로샷 메트릭 뎁스):
- 별도의 카메라 파라미터 파일(
calib.txt)이 없어도, 네트워크가 이미지 자체의 시각적 단서를 통해 카메라 초점거리를 역추정하고 각 픽셀의 절대 미터($m$) 거리를 0.3초 만에 직접 출력합니다. - 전신주 전선이나 가느다란 표지판 기둥까지 날카롭게 살려내는 놀라운 에지 해상도를 보여줍니다.
- 별도의 카메라 파라미터 파일(
- Depth Anything 3 (DA3):
- 깊이(Depth)뿐 아니라 픽셀에서 뻗어나가는 광선 벡터(Ray Vector)를 동시에 추론하여, 복잡한 투영 변환 없이 픽셀 곱셈만으로 완벽한 3D 공간 좌표계를 복원합니다.
- 서라운드 멀티 뷰 카메라를 하나로 묶어 차량 주변 360도 공간 전체를 탑뷰(BEV) 평면 지도로 즉시 융합해 냅니다.
자주 묻는 질문 (FAQ)
Q. 뎁스 맵 거리 정보만 있으면 자율주행 차량의 조향과 제동이 가능한가요?
- 불가능합니다. 단순 거리 정보는 “전방 15m 지점에 물체가 있다”는 기하학적 형태만 알려줄 뿐, 그것이 ‘밟고 지나가도 되는 맨홀 뚜껑’인지 ‘반드시 멈춰야 하는 콘크리트 연석이나 보행자’인지 구별하지 못합니다.
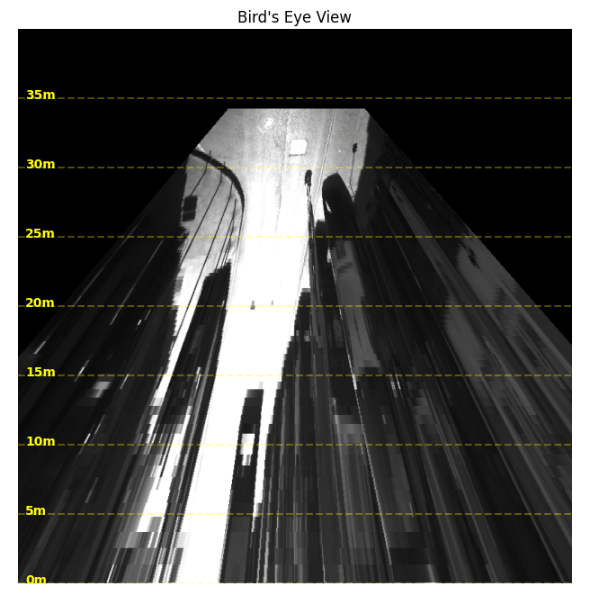
- 따라서 물체의 클래스를 인식하는 의미론적 분할(Semantic Segmentation) 및 객체 검출(Object Detection)과 융합되어야 하며, 차량 흔들림을 보정한 탑뷰(BEV, Bird’s-Eye-View) 평면 격자 지도로 변환되어야 안전한 주행 궤적(Path Planning)을 생성할 수 있습니다.
핵심 레퍼런스 및 논문 (References)
- Depth Anything V2: A More Capable Foundation Model for Monocular Depth Estimation (Yang et al., 2024, arXiv:2406.09414)
- 대규모 고품질 합성 데이터 학습과 의사 레이블링(Pseudo-labeling)을 통해 기존 모델 대비 경계선 분해능과 노이즈 억제력을 비약적으로 끌어올린 대표 뎁스 파운데이션 모델입니다.
- Depth Pro: Sharp Monocular Metric Depth in Less Than a Second (Bochkovskii et al., Apple, 2024, arXiv:2410.02073)
- 카메라 캘리브레이션 정보(
calib) 없이도 단일 이미지를 넣는 즉시 0.3초 만에 픽셀별 절대 거리($m$)를 초고해상도로 직접 뽑아내는 애플의 제로샷 메트릭 뎁스 모델입니다.
- 카메라 캘리브레이션 정보(
- Are we ready for Autonomous Driving? The KITTI Vision Benchmark Suite (Geiger et al., CVPR 2012)
- 자율주행 컴퓨터 비전 연구의 사실상 표준인 KITTI 데이터셋 논문으로, 실습에서 활용한 스테레오 카메라 투영 행렬($P_2$)과 OXTS 관성 센서(IMU/GPS) 규격을 정립했습니다.
- Inverse Perspective Mapping (IPM) in Automotive Vision (Mallot et al., 1991)
- 노면이 평평하다는 지면 제약과 카메라 설치 각도(Pitch, Roll)를 역투영하여 2D 이미지를 왜곡 없는 탑뷰(BEV) 평면 지도로 변환하는 고전 기하학의 핵심 원리를 다룹니다.
“[모노뎁스] 카메라로 거리를 측정하는 법: 자율주행 비전, 기하학 보정 가이드 4편”에 대한 1개의 생각