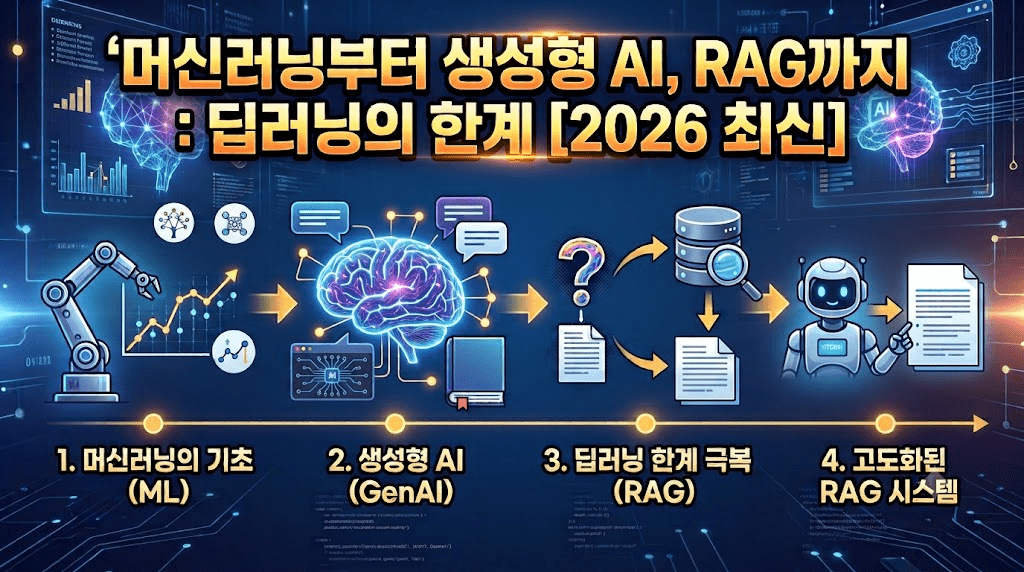
이전까지는 자율주행, 블로그 만들기를 해보았습니다! 다음 주제로는 AI입니다!! 인공지능(AI) 머신러닝, 딥러닝, 생성형 AI기술은 눈부신 속도로 발전하고 있습니다. 단순한 데이터 분류와 예측을 수행하던 전통적인 머신러닝(Machine Learning)에서 시작해, 이제는 인간처럼 글을 쓰고 코드를 작성하는 생성형 AI(Generative AI)의 시대로 진입했습니다. 이제는 GPT6 Astra의 등장으로 AGI의 시대를 열었다고 하죠.
딥러닝과 생성형 AI가 완벽한 것만은 아닙니다. AI가 사실이 아닌 정보를 그럴듯하게 지어내는 환각(Hallucination) 현상과 같은 도전 과제가 여전히 존재하며, 이를 극복하기 위해 RAG(검색 증강 생성) 와 같은 최신 기술이 필수적으로 요구되고 있습니다.
이번 포스팅에서는 머신러닝의 기초부터 생성형 AI LLM, 그리고 RAG를 통한 딥러닝 한계 극복까지 파이썬(Python) 실습 코드와 함께 상세히 알아보겠습니다.
머신러닝의 기초: 데이터로 미래를 예측하다
인공지능의 가장 기초적인 형태는 수치화된 데이터를 기반으로 특정 결과를 예측하거나 분류하는 머신러닝입니다. 대표적인 기법으로 결정 트리 기반의 랜덤 포레스트(Random Forest) 와 트리를 부스팅하는 XGBoost가 있습니다.
랜덤 포레스트(Random Forest)의 예시로 “나이와 액션 영화 선호도를 바탕으로 특정 영화 관람 여부를 예측하는” 코드를 준비했습니다.
import pandas as pd
from sklearn.ensemble import RandomForestClassifier

# 1. 초보자용 가상 데이터 준비
# age: 나이, action_score: 액션 영화 선호도(1~10점), watched: 어벤져스 관람 여부(1=관람, 0=미관람)
data = pd.DataFrame({
    "age": [15, 25, 35, 45, 20],
    "action_score": [8, 9, 4, 3, 7],
    "watched": [1, 1, 0, 0, 1]
})

# 입력 데이터(X)와 정답 데이터(y) 분리
X = data[["age", "action_score"]]
y = data["watched"]

# 2. 랜덤 포레스트 머신러닝 모델 학습
model = RandomForestClassifier(random_state=42)
model.fit(X, y)

# 3. 새로운 관람객 예측해보기 (30살, 액션 선호도 8점인 사람)
new_user = pd.DataFrame({"age": [30], "action_score": [8]})
prediction = model.predict(new_user)

print("관람 예측 결과 (1이면 관람, 0이면 미관람):", prediction[0])이처럼 머신러닝은 표(Table) 형태로 정리된 명확한 수치 데이터를 분석하는 데 매우 탁월한 성능을 발휘합니다.
XGBoost를 당뇨병 고위험군 조기 판별
의료 진단 분야에서는 단순 예측을 넘어 모델의 정량적인 신뢰도 지표가 필수적입니다. XGBoost(Extreme Gradient Boosting)는 오차를 단계적으로 줄여나가는 부스팅(Boosting) 방식을 사용하여 복잡한 환자 생체 지표 분류에서 뛰어난 성능을 보입니다.
실제 당뇨 환자 442명의 임상 데이터(혈압, 체질량지수, 콜레스테롤 등 10개 지표)를 담은 Scikit-learn 공식 내장 당뇨병 데이터셋을 활용하여 당뇨 고위험군을 분류하는 예시 코드입니다.
import xgboost as xgb
import numpy as np
from sklearn.datasets import load_diabetes
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# 1. Scikit-learn 공식 당뇨병 임상 데이터셋 로딩 (환자 442명)
data = load_diabetes()
X = data.data

# 2. 임상 기준 라벨링 (질환 진행도 수치 중앙값 기준: 1 = 고위험군, 0 = 정상군)
median_val = np.median(data.target)
y = (data.target > median_val).astype(int)

# 3. 학습용과 검증용 데이터 분할 (8:2 비율, random_state 고정)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 4. XGBoost 분류 모델 생성 및 학습
model = xgb.XGBClassifier(
    n_estimators=100,
    max_depth=3,
    learning_rate=0.05,
    eval_metric='logloss',
    random_state=42
)
model.fit(X_train, y_train)

# 5. 검증 데이터 예측 및 정확도 수치 출력
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)

print(f"진단 분류 정확도 (Accuracy): {accuracy * 100:.2f}%")위 코드를 직접 실행하면 테스트 환자군에 대해 75.28%의 진단 정확도가 실제 수치로 즉시 출력됩니다. 가공되지 않은 복잡한 실제 인체 생체 지표 데이터임에도 불구하고, 4명 중 3명의 고위험 환자를 정확하게 사전 스크리닝해내는 실질적인 성능을 확인할 수 있습니다.
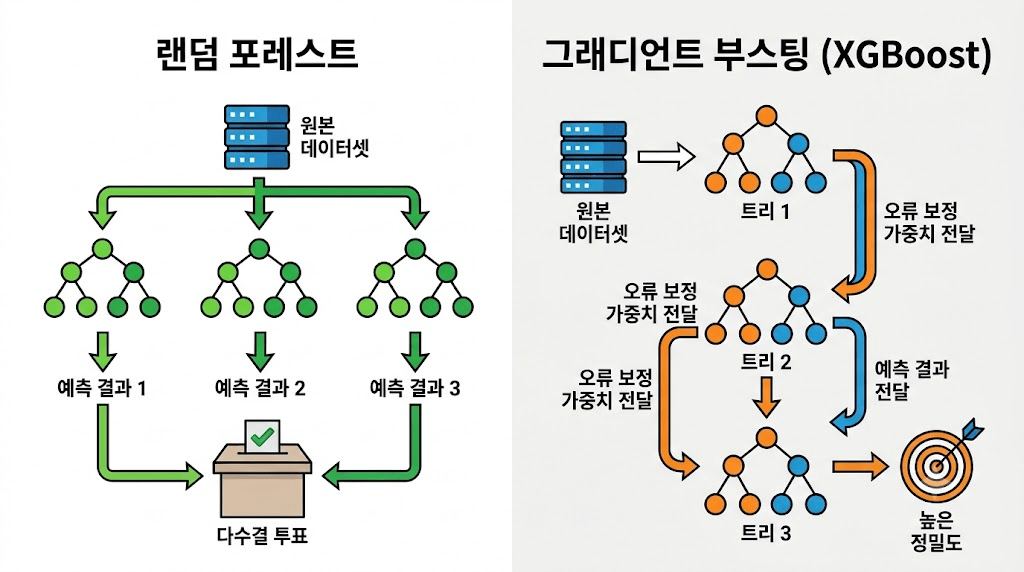
| 비교 항목 | 랜덤 포레스트 (Random Forest) | XGBoost (Extreme Gradient Boosting) |
| 앙상블 방식 | 배깅 (Bagging, 병렬 학습) | 부스팅 (Boosting, 순차 학습) |
| 작동 원리 | 여러 독립된 트리를 동시에 무작위로 골라 학습시켜 투표/평균 | 이전 트리가 틀린 오차를 다음 트리가 순차적으로 보완 |
| 목적 | 모델의 분산(Variance) 감소 (과적합 방지) | 모델의 편향(Bias) 감소 (예측 정확도 극대화) |
| 학습 속도 | 각 트리가 독립적이어서 병렬 처리가 빠름 | 순차적으로 학습하여 상대적으로 학습 시간이 더 소요됨 |
| 과적합 위험 | 트리가 많아져도 과적합 위험이 상대적으로 적음 | 학습률이나 깊이 조절을 잘못하면 과적합되기 쉬움 |
| 튜닝 난이도 | 기본 설정값으로도 안정적인 성능을 냄 | 하이퍼파라미터 튜닝(학습률, 깊이 등)이 성능에 큰 영향 |
| 장점 | 데이터에 노이즈나 이상치가 많아도 안정적 | 정형 데이터 분석 및 캐글(kaggle) 등 고성능를 낼 때 사용됨. |
딥러닝과 트랜스포머(Transformer)의 등장
머신러닝은 훌륭하지만, 텍스트나 이미지 같은 비정형 데이터로 넘어가면서 딥러닝(Deep Learning) 이 필수적이 되었습니다. 특히 언어 처리 분야에서는 순환 신경망(RNN, LSTM)이 초기 성과를 이끌었습니다.
하지만 텍스트를 처리하는 초기 딥러닝 모델(RNN, LSTM 등)은 문장이 길어지면 앞서 학습한 내용을 잊어버리는 치명적인 한계(장기 의존성 문제)를 가지고 있었습니다.
이를 혁신적으로 극복한 것이 바로 문장 속 모든 단어의 관계를 동시에 파악하는 ‘어텐션(Attention)’ 기반의 트랜스포머(Transformer) 모델입니다. 트랜스포머 덕분에 복잡한 자연어 처리도 몇 줄의 코드로 구현할 수 있게 되었습니다.
긍정/부정 감성 분석(Sentiment Analysis) 예시 코드입니다
# 파이썬에서 트랜스포머 모델을 쉽게 쓰게 해주는 라이브러리 설치 필요 (pip install transformers)
from transformers import pipeline

# 1. 감성 분석(긍정/부정 판단) AI 파이프라인 불러오기
classifier = pipeline("sentiment-analysis")

# 2. 분석하고 싶은 문장 입력
text1 = "I really love learning about Generative AI! It's so fun."
text2 = "This code is too difficult and frustrating."

# 3. 결과 확인
print("첫 번째 문장 분석:", classifier(text1))
print("두 번째 문장 분석:", classifier(text2))기존에 수백 줄의 수학 공식이 필요했던 딥러닝이 이제는 트랜스포머를 통해 단 3줄의 코드로 완성됩니다.
LLM(Large Language Model)의 세계
Open Weight 모델: LLaMA 3.2 직접 실행하기
메타(Meta)의 LLaMA 3.2와 같은 Open Weight 모델은 로컬 환경에서도 실행할 수 있어 데이터 보안에 유리합니다. (주의: Hugging Face에서 사용 승인 및 토큰 발급이 필요합니다)
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

hf_token = "YOUR_HF_TOKEN"
model_name = "meta-llama/Llama-3.2-1B-Instruct"

# 토크나이저 및 모델 로드
tokenizer = AutoTokenizer.from_pretrained(model_name, token=hf_token)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.bfloat16,  # 최신 GPU/LLaMA 3 계열은 float16보다 bfloat16 권장
    device_map="auto",
    token=hf_token
)

# 1. 채팅 템플릿 구성 (필수)
messages = [
    {"role": "user", "content": "What is Transformer Model?"}
]
prompt = tokenizer.apply_chat_template(
    messages,
    add_generation_prompt=True,
    return_tensors="pt"
).to(model.device)

# 2. 추론 (temperature 사용 시 do_sample=True 필수)
outputs = model.generate(
    prompt,
    max_new_tokens=1024,
    do_sample=True,
    temperature=0.7,
    pad_token_id=tokenizer.eos_token_id
)

# 3. 입력 프롬프트를 제외하고 새로 생성된 응답만 디코딩
generated_tokens = outputs[0][prompt.shape[-1]:]
response = tokenizer.decode(generated_tokens, skip_special_tokens=True)

print("LLaMA 응답:\n", response)이러한 오픈 모델들은 로컬 PC로 다운로드하여 인터넷 없이도 실행할 수 있다는 큰 장점을 갖습니다.
Closed 모델: OpenAI API 활용
반면, API를 활용해 고성능 Closed 모델을 애플리케이션에 통합할 수도 있습니다. 예를 들어 학생의 취약점을 파악하여 맞춤형 영어 퀴즈를 자동 생성하는 코드입니다
from openai import OpenAI

# 본인이 발급받은 OpenAI API 키 입력
client = OpenAI(api_key="YOUR_OPENAI_API_KEY")

# 학생의 취약점 분석 결과 (예: 과거형 동사)
student_weak_point = "영어의 불규칙 과거형 동사"

# 프롬프트 엔지니어링: AI에게 역할과 구체적인 지시를 내림
prompt = f"""
당신은 친절한 영어 선생님입니다.
학생이 '{student_weak_point}' 단원을 매우 어려워하고 있습니다.
초보자 수준에 맞춘 재미있는 객관식 연습 문제 1개와, 정답 및 쉬운 해설을 만들어주세요.
"""

response = client.chat.completions.create(
    model="gpt-3.5-turbo",
    messages=[{"role": "user", "content": prompt}],
    temperature=0.7 # 창의성 조절 (0~2)
)

print(response.choices[0].message.content)이러한 LLM 기술은 교육 분야에도 접목되어, 개인화된 학습 에이전트로 진화하고 있습니다.
| 구분 | 폐쇄형 모델 (Closed Model) | 오픈 가중치 모델 (Open Weight Model) |
| 대표 예시 | OpenAI (GPT), Anthropic (Claude), Google (Gemini) 그록 | Meta (LLaMA 계열), Mistral AI 등 |
| 모델 다운로드 | 불가능 (클라우드 서버에만 존재) | 가능 (로컬 PC나 자체 서버에 직접 다운로드) |
| 작동 방식 | API 통신이나 웹 인터페이스로만 접근 | 로컬 환경에서 단독 구동 가능 (오프라인 구동 가능) |
| 내부 공개 여부 | 가중치, 데이터셋, 구체적 아키텍처 비공개 | 모델 가중치(Weight) 및 실행 코드 공개 |
| 보안 및 프라이버시 | 데이터를 상대방 서버(OpenAI 등)로 전송해야 함 | 로컬 환경에 두면 외부 데이터 유출 위험 없음 |
| 비용 방식 | 사용량(토큰 수)당 요금 결제 | 모델은 무료 제공 (직접 돌릴 하드웨어/GPU 비용 발생) |
오늘날 우리가 아는 gpt, 클로드, 제미나이, 그록 같은 대형 언어 모델(LLM) 들이 탄생했습니다. 현재 시장은 크게 폐쇄형(Closed) 모델과 오픈 가중치(Open Weight) 모델로 나뉩니다.
생성형 AI의 한계와 도전 과제
생성형 AI는 완벽하지 않습니다. 가장 큰 문제점은 사실이 아닌 내용을 진짜처럼 말하는 환각(Hallucination) 현상입니다.
AI 모델은 단어와 단어 사이의 ‘확률’을 기반으로 다음 단어를 예측하여 생성하기 때문에, 자신이 모르는 정보(최신 정보, 특정 회사의 내부 기밀 데이터 등)에 대해서도 ‘모른다‘고 대답하지 않고 엉뚱한 문장을 만들어내는 치명적인 한계가 있습니다
또한 최신 정보의 부재, 특정 도메인(기업 내부 데이터 등) 지식의 부족 등이 생성형 AI의 주요 한계점(도전 과제)으로 꼽히고 있습니다.
이를 극복하기 위해 등장한 것이 바로 검색 증강 생성(RAG, Retrieval-Augmented Generation) 과 벡터 데이터베이스(Vector DB), 그리고 최적화된 프롬프트 엔지니어링(Prompt Engineering)입니다.
RAG와 Vector DB: ‘NEXT’ AI 시대의 돌파구
RAG는 질문에 답하기 전, 모델이 외부 지식 베이스(문서, DB 등)를 먼저 검색(Retrieval)하여 관련 정보를 찾은 뒤 이를 프롬프트에 증강(Augmented)하여 답변을 생성(Generation)하는 기술입니다. 이를 위한 위한 핵심 기술 세 가지가 바로 프롬프트 엔지니어링(Prompt Engineering), Vector DB(벡터 데이터베이스), 그리고 RAG(검색 증강 생성)입니다.
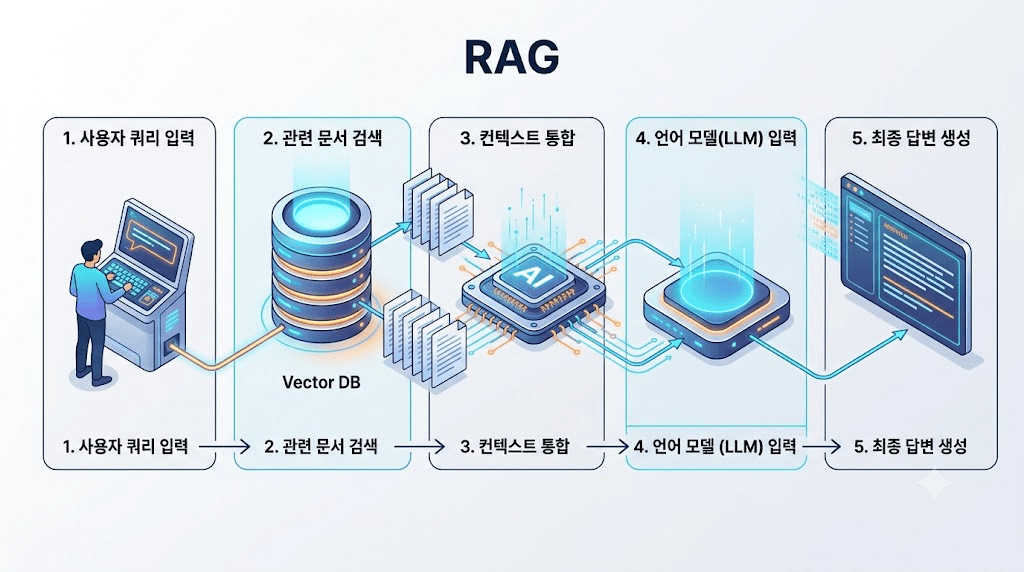
RAG (검색 증강 생성): AI에게 질문을 던졌을 때 AI가 바로 대답하는 것이 아니라, 먼저 신뢰할 수 있는 외부 문서나 데이터베이스에서 관련 정보를 ‘검색(Retrieval)’한 뒤, 그 정확한 정보를 바탕으로 답변을 ‘생성(Generation)’하는 기술입니다.
Vector DB: 컴퓨터가 문장의 의미를 이해하고 가장 비슷한 문서를 빠르게 검색할 수 있도록, 텍스트를 숫자의 좌표(Vector)로 변환하여 저장하는 차세대 데이터베이스입니다.
LangChain과 FAISS를 활용한 고도화된 RAG 시스템 구축
실무에서는 랭체인(LangChain) 프레임워크와 Vector DB(FAISS) 를 결합하여 고도화된 RAG를 구현합니다. 긴 문서를 작은 단위로 쪼개어 벡터 DB에 인덱싱한 후, 사용자의 질문과 가장 유사한 문단을 검색해 답변을 생성하는 파이프라인입니다.
Python
from langchain.text_splitter import CharacterTextSplitter
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import FAISS
from langchain_core.messages import HumanMessage
import os

os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"

# 1. 신뢰할 수 있는 외부 지식 정보(사내 카페 규정) 준비
cafe_policy = """
사내 카페 'NEXT COFFEE'의 아메리카노 가격은 1,500원입니다.
카페라떼는 2,000원이며, 딸기 스무디는 3,000원입니다.
개인 텀블러를 지참하시면 모든 음료에서 300원이 할인됩니다.
"""

# 2. 문서 쪼개기 및 Vector DB(FAISS)에 저장하여 인덱싱
splitter = CharacterTextSplitter(chunk_size=50, chunk_overlap=10)
docs = splitter.create_documents([cafe_policy])

# 텍스트를 벡터로 변환(Embedding)하여 DB에 저장
vector_db = FAISS.from_documents(docs, OpenAIEmbeddings())

# 3. 사용자 질문에 맞춰 Vector DB에서 관련 정보 검색
query = "텀블러 가져가면 딸기 스무디는 얼마야?"
searched_docs = vector_db.similarity_search(query, k=1)
retrieved_info = searched_docs[0].page_content

# 4. 프롬프트 엔지니어링 및 LLM 답변 생성
prompt = f"""
다음은 사내 카페의 공식 규정입니다:
{retrieved_info}

사용자의 질문: {query}
위 공식 규정을 바탕으로 정확하게 계산하여 친절하게 답변해주세요.
"""

llm = ChatOpenAI(model="gpt-3.5-turbo", temperature=0)
answer = llm.invoke([HumanMessage(content=prompt)]).content

print("💡 AI 바리스타 답변:\n", answer)이 방식을 사용하면 기업의 사내 규정, 고객 매뉴얼 등 비공개(Closed) 데이터나 최신 정보를 바탕으로 환각 없는 정확한 AI 답변 에이전트를 구축할 수 있습니다.
결론: 딥러닝의 진화와 NEXT 스텝
전통적 머신러닝의 분류/예측 모델부터, 트랜스포머 기반의 거대 언어 모델(LLM), 그리고 딥러닝 모델의 본질적 한계를 극복하는 RAG(검색 증강 생성) 기술과 프롬프트 엔지니어링까지 살펴보았습니다.
AI 기술은 단순한 알고리즘의 개선을 넘어, 벡터 DB와 RAG 구조를 통해 지식을 효율적으로 탐색하고 통합하는 방향으로 고도화되고 있습니다. 여러분도 위에서 소개한 파이썬 코드들을 직접 실습해 보며, ‘NEXT’ AI 시대를 주도할 나만의 생성형 AI 애플리케이션 구축에 도전해 보시길 바랍니다!
자주 묻는 질문 (FAQ)
Q1. RAG(검색 증강 생성)와 미세조정(Fine-tuning) 중 어떤 방식을 선택해야 하나요?
- RAG 추천: 실시간 최신 정보 반영이 필요하거나, 기업 내부 보안 문서처럼 데이터가 자주 변경되는 경우, 환각을 방지하고 출처 검증이 중요한 경우에 적합합니다. 구축 비용과 인프라 부담이 상대적으로 적습니다.
- Fine-tuning 추천: 모델에게 특정한 말투(톤앤매너), 정형화된 JSON 출력 포맷, 혹은 아주 특수한 도메인 문법 체계를 고정적으로 학습시켜야 할 때 유리합니다. 단, 주기적인 데이터 재학습 비용이 발생합니다.
Q2. 폐쇄형(Closed API) 모델과 오픈 가중치(Open Weight) 모델은 실무에서 어떻게 선택하나요?
- 초기 프로토타이핑이나 범용적인 고성능 추론이 필요한 단계에서는 GPT, Claude, Gemini과 같은 폐쇄형 API를 활용하는 것이 개발 속도와 인프라 운영 면에서 효율적입니다.
- 반면 금융·의료·공공기관처럼 민감한 개인정보나 사내 기밀을 다뤄 외부 서버 전송이 불가한 경우, LLaMA 계열과 같은 오픈 가중치 모델을 사내 온프레미스(On-Premise) 또는 프라이빗 클라우드에 직접 올려 보안을 확보하는 전략을 취합니다.
Q3. Vector DB(벡터 데이터베이스)는 기존 RDBMS(SQL)와 무엇이 다른가요?
- 기존 RDBMS는 특정 키워드가 정확히 일치(Exact Match)해야 데이터를 검색합니다.
- Vector DB는 텍스트를 고차원 숫자 벡터(임베딩)로 변환하여 저장한 뒤 ‘의미적 유사도(Semantic Similarity, 코사인 유사도 등)’를 계산합니다. 따라서 질문과 문서의 표현 단어가 완전히 일치하지 않더라도 문맥과 의도가 유사한 데이터를 찾아낼 수 있습니다.
Q4. RAG를 도입해도 여전히 오답을 내는 경우가 발생하는 이유는 무엇인가요?
- 검색 단계의 실패: 텍스트 분할(Chunking) 단위가 너무 작거나 커서 질문에 필요한 핵심 문맥이 벡터 DB 검색 결과(Top-k)에 포함되지 않은 경우입니다.
- 생성 단계의 실패: 검색된 문맥은 정확하나 프롬프트 구조가 모호하여 LLM이 제공된 문맥을 무시하고 자체 지식(Prior Knowledge)을 우선 참조해 환각을 일으키는 경우입니다.
References
트랜스포머 아키텍처 (Transformer & Attention)
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems (NeurIPS 2017).
검색 증강 생성 원저 (RAG Architecture)
Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W., Rocktäschel, T., Riedel, S., & Kiela, D. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Advances in Neural Information Processing Systems (NeurIPS 2020).
LangChain 공식 문서 (python.langchain.com)
RAG 파이프라인 구성의 핵심 도구로, 본문 실습에 쓰인 RecursiveCharacterTextSplitter, VectorStores, ChatOpenAI 모듈의 최신 인터페이스를 제공합니다[cite: 9].
Hugging Face Transformers 공식 문서 (huggingface.co)AutoModelForCausalLM, AutoTokenizer 및 LLaMA 3.2 모델 가중치를 다운로드하고 로컬 파이프라인을 구축할 때 참조하는 표준 문서입니다.
OpenAI API 레퍼런스 (platform.openai.com)client.chat.completions.create API 호출 규격, gpt-4o 및 gpt-3.5-turbo 모델 파라미터(temperature, max_tokens) 설정 기준 가이드입니다.
FAISS 공식 GitHub (facebookresearch/faiss)
대규모 밀집 벡터(Dense Vector) 클러스터링 및 효율적인 코사인 유사도 연산을 지원하는 오픈소스 벡터 인덱싱 라이브러리 저장소입니다
“머신러닝부터 생성형 AI, RAG까지 : 딥러닝의 한계 [2026 최신] 1편”에 대한 2개의 생각